AI 기술이 발전하며 금융 및 주식 정보를 수집하는 시대가 열렸으나 기존 시스템은 단순 요약에 그친다. 퍼플렉시티가 공개한 새로운 오픈 벤치마크 WANDR은 AI 리서치 에이전트의 광범위한 정보 수집과 철저한 증거 기반 조사 역량을 평가하여 자율형 분석 기술의 새로운 도약대를 제시한다.
AI 리서치 에이전트의 새 기준, WANDR
기존 AI 성능 평가는 단순 질의응답이나 문서 요약 수준에 머물러 복잡한 시장 조사를 수행하는 에이전트의 실력을 검증하기 어려웠다. WANDR은 대규모 증거 기반 지식 작업을 정확히 평가하기 위해 탄생한 도구다.
이 벤치마크는 자격을 갖춘 대상을 널리 탐색하는 '광범위한' 검색과, 수집한 정보의 타당성을 입증하는 '심층적인' 조사를 동시에 요구한다. 이로써 단순 정보 취합을 넘어 실제 연구원처럼 작동하는지 평가한다.
꼬리를 무는 계층적 정보 탐색 능력 검증
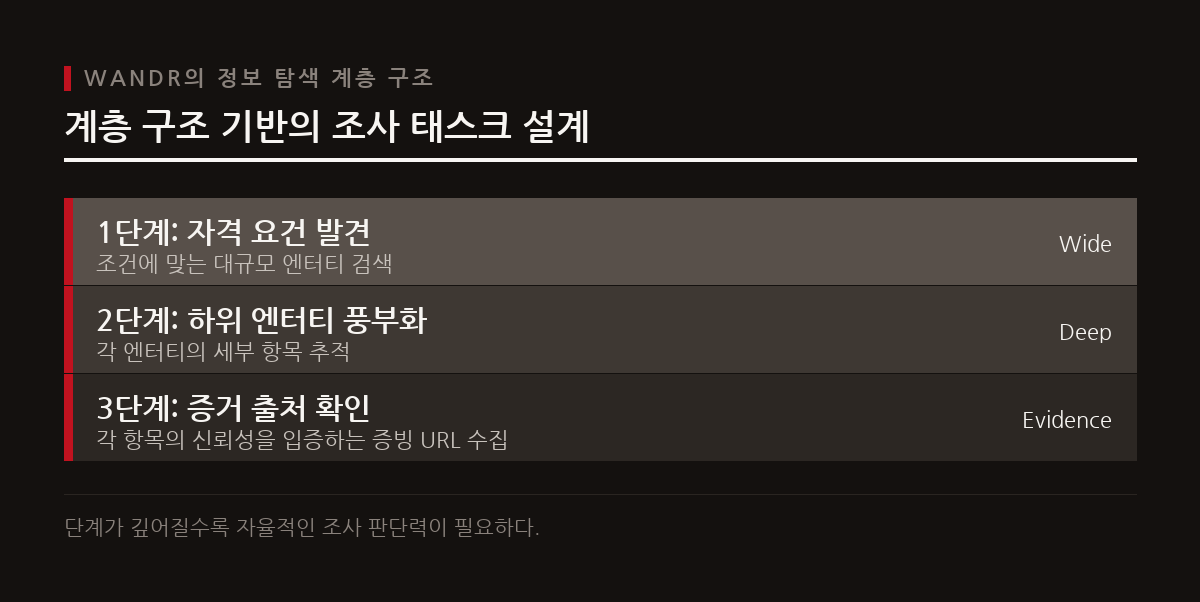
WANDR은 회사에서 직원, 그리고 증빙 웹페이지로 꼬리를 물고 이어지는 다단계 계층 구조의 탐색 태스크를 설계해 AI의 역량을 시험한다. 2026년 봄철 임원을 발표한 미국 기업 70개와 관련 증빙 웹페이지를 포함해 총 140개의 기록을 수집하는 과제가 대표적이다.
이러한 계층 구조를 기반으로 조사를 수행할 때 목표 수량이 늘어나고 계층의 깊이가 깊어질수록 최고 수준의 AI 시스템마저 정보 탐색 성공률이 크게 떨어지는 취약점을 드러낸다.
진짜 증거인지 끝까지 추적하는 검증법
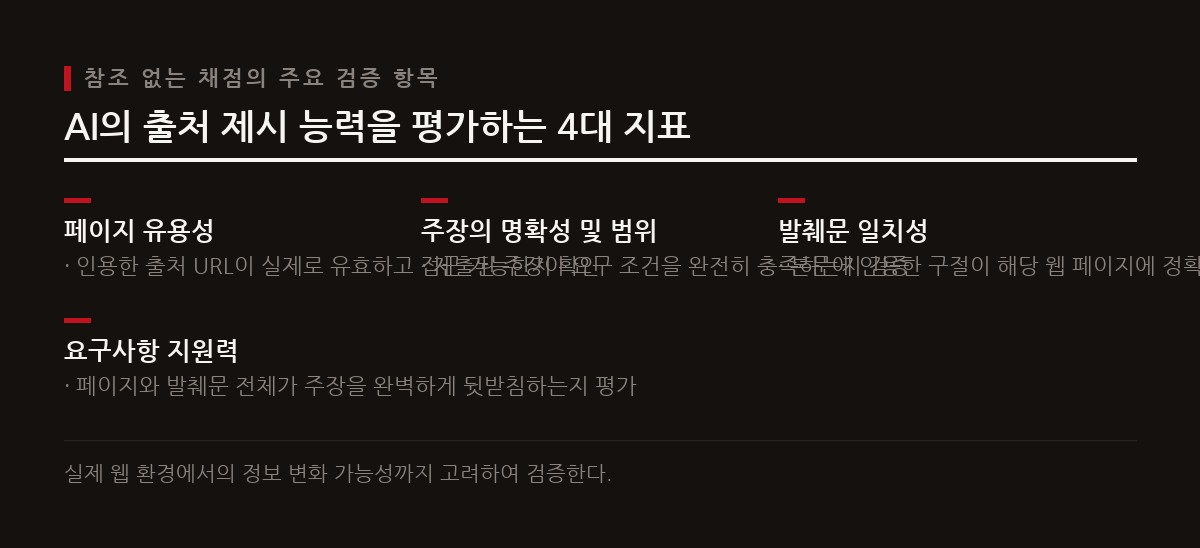
이 벤치마크는 고정된 모범 답안 대신 AI가 제시한 출처의 신뢰성을 실시간으로 확인하는 '참조 없는 채점'을 도입했다. AI가 답변에 사용한 URL 링크가 유효한지, 발췌한 문장이 실제 본문과 일치하는지를 정밀하게 추적한다.
출처 제시 능력을 평가하기 위해 정밀도, 재현율, F1 점수를 부분 점수 기준(소프트)과 완벽 일치 기준(하드)으로 분류한 4대 지표를 적용한다. 또한 실패 원인을 분석하도록 계층별 세부 점수와 판정을 제공한다.
최신 AI 모델들도 낙제점 기록
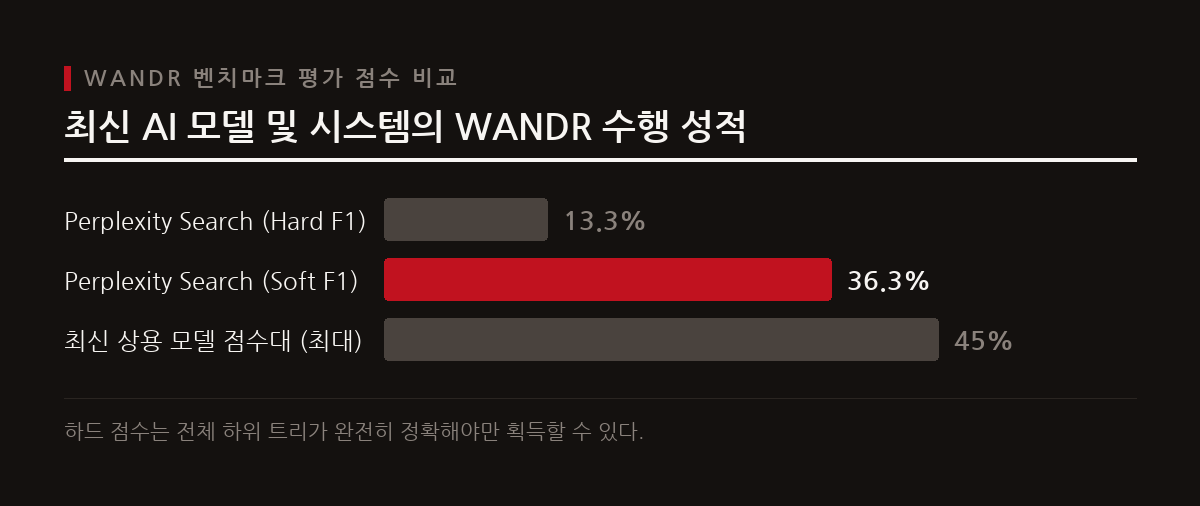
현재 시장을 주도하는 최첨단 AI 모델조차 이 엄격한 검증대 앞에서는 낙제점에 가까운 점수를 기록했다. 퍼플렉시티의 자체 시스템은 소프트 F1 점수 36.3%, 하드 F1 점수 13.3%에 머무르며 심각한 정보 완수 한계를 드러냈다.
GPT-5.6, Claude Fable 5, Gemini 3.5 등의 최고 사양 상용 모델들 역시 35~45% 수준의 성적에 그쳤다. 이는 실시간 인터넷 웹 환경에서 자율적이고 신뢰성 있게 조사를 완수하는 영역이 여전히 미개척 영역임을 보여준다.
진짜 조사하는 AI가 가져올 변화
WANDR은 단순 챗봇을 넘어 스스로 가치를 증명하는 자율형 리서치 에이전트로의 진화 방향을 보여준다. 개인 투자자가 당장 개별 기업 분석과 거시 정보 취합을 AI에 완벽히 의존하기에는 기술적 공백이 크다.
그러나 기술 기업들이 WANDR의 높은 장벽을 극복하며 에이전트의 검증 능력을 높여간다면 시장의 투자 정보 비대칭성은 획기적으로 개선될 것이다. 향후 리서치 시장의 주도권은 이 평가를 극복하는 기업이 쥐게 된다.
참고
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.