실제 환경의 비디오를 분석하여 로봇이 움직일 수 있는 가상의 3D 시뮬레이션 공간으로 변환하는 기술은 체화된 AI 분야의 핵심 과제다. 기존 스캔 방식은 개별 객체의 조작이 어려웠으나 바이트댄스 시드 연구진이 개발한 루시다는 이를 극복했다. 루시다는 실내 비디오 속 물체들을 편집 및 조작이 가능한 완전한 3D 자산으로 복원해 낸다.
비디오를 편집 가능한 3D 공간으로 바꾸는 루시다
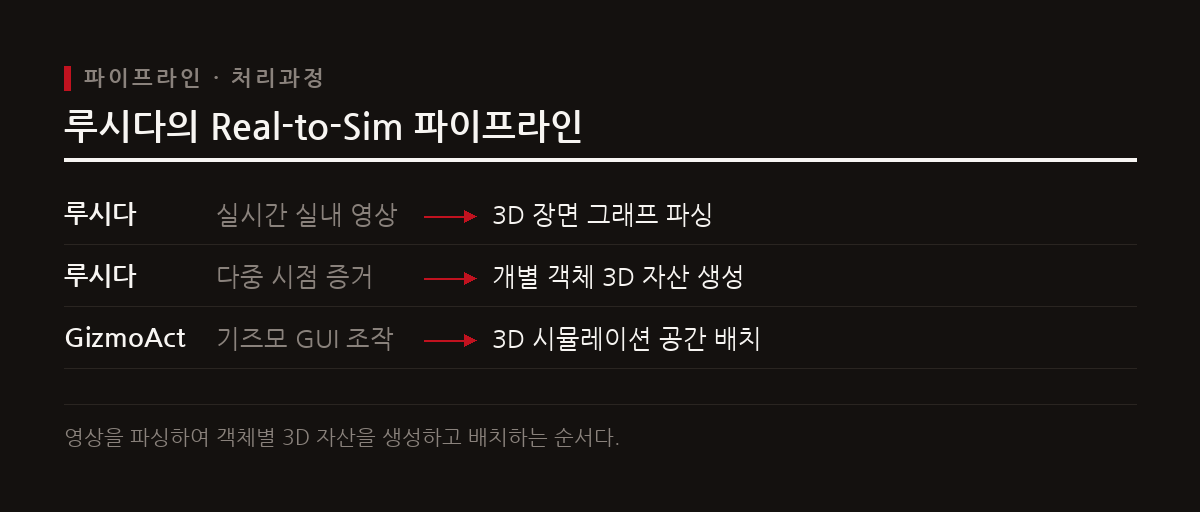
바이트댄스 시드 연구진이 공개한 루시다는 실내 영상을 로봇 시뮬레이션 및 체화된 AI 개발을 위한 3D 환경으로 정교하게 변환하는 기술이다. 비디오 속 실제 객체들을 관찰된 상태 그대로 완전하고 편집 가능한 3D 자산으로 복원하는 데 초점을 맞춘다.\n\n이 기술은 실세계를 가상 공간으로 옮기는 Real-to-Sim 파이프라인을 근간으로 삼는다. 통째로 장면을 스캔하는 대신 개별 객체 단위로 분리하여 복원하므로 로봇 학습을 위한 고도화된 가상 환경을 신속하게 구현하는 장점을 제공한다.
객체 파싱부터 GizmoAct 배치까지의 핵심 동작
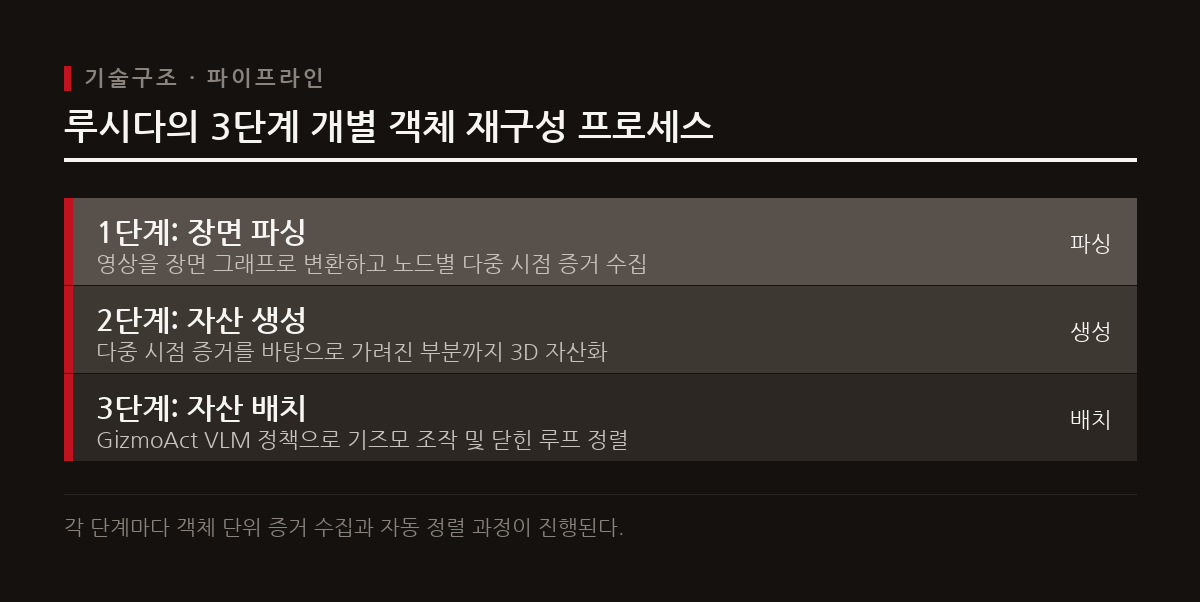
루시다는 비디오 영상을 장면 그래프로 파싱하고 각 노드에서 인스턴스별 다중 시점 증거를 추출한다. 연구진이 마스크나 포인트클라우드 수집을 직접 진행하는지는 명시되지 않았으나 다중 시점 정보를 활용해 가려진 부분까지 정교하게 추정한다. 이 개별 객체 재구성은 체계적인 3단계 프로세스를 거쳐 완료된다.\n\n자산 배치는 비전 언어 모델 정책인 GizmoAct가 수행한다. GizmoAct는 다중 턴 GUI 상호작용을 통해 3D 기즈모를 조작하며 객체를 정교하게 배치한다. 시스템은 닫힌 루프 피드백을 통해 정렬 완료 여부를 스스로 결정하며 정밀한 조정을 마무리한다.
기존 모델 대비 주요 성능 지표 비교
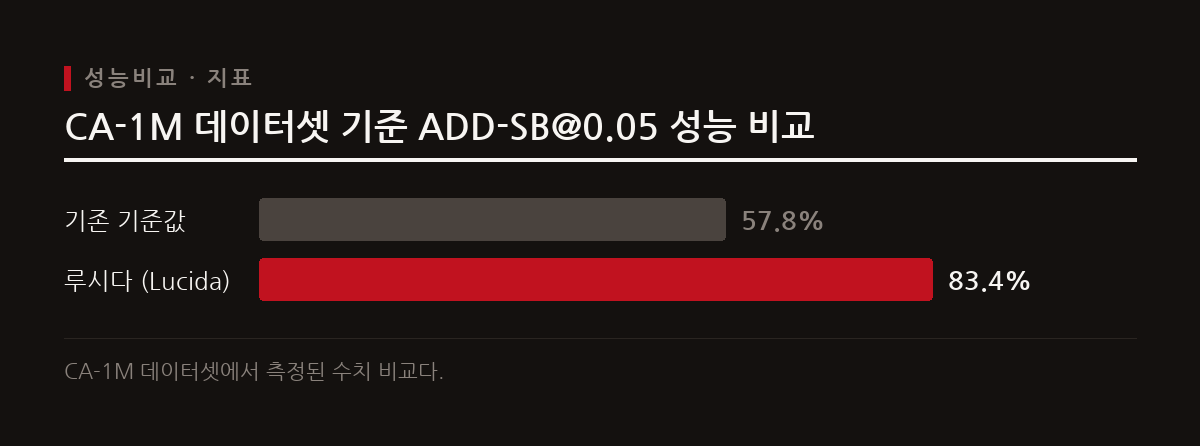
루시다는 3D 객체 감지 및 장면 재구성 벤치마크 평가에서 우수한 성과를 보였다. 장면 수준의 3D 객체 감지에서는 Boxer 대비 mAP를 69% 향상시켰고, 장면 분할을 측정하는 F-점수 평가에서는 SAM3D가 기록한 0.794를 크게 넘어선 0.924의 높은 성적을 달성했다.\n\n특히 자세 추정 정확도를 보여주는 [email protected] 성능 평가에서도 강력한 개선을 보였다. CA-1M 데이터셋 기준으로 기존의 벤치마크 모델들이 기록했던 57.8% 정확도 수치를 루시다는 83.4%까지 높였다. 이러한 결과는 물리적 시뮬레이션의 정확도를 보장하는 핵심 지표다.
로봇 시뮬레이션과 체화된 AI를 위한 고도화
체화된 AI 분야에서 루시다는 수작업 기반의 가상 환경 구축 과정을 완전히 자동화한다. 실생활에서 간단히 촬영한 비디오만으로도 로봇이 쥐고 흔들 수 있는 개별 조작 자산 단위를 가상 공간 안에 즉각적으로 생성할 수 있기 때문이다.\n\n다중 턴 상호작용과 자율 정렬 성능을 활용하면 대규모 로봇 학습용 데이터셋 생성이 수월해진다. AI를 직접 활용하는 개발자라면 루시다의 오픈소스를 참고하여 실제 공간을 기반으로 한 정밀한 시뮬레이션 환경 구축에 직접 도전해보기를 제안한다.
참고
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.