 유명한형제들
인공지능 서비스가 클라우드에서만 돌던 방식에서 로컬 기기를 함께 쓰는 하이브리드 컴퓨팅으로 옮겨 가고 있다. 이런 흐름 속에서 Perplexity가 자사 서비스의 로컬 연산을 맡는 엔진을 공개했다. 로컬 기기의 한정된 자원을 최대한 쓰려고 범용성을 버리고 특정 하드웨어와 모델에만 맞춰 최적화한 것이 핵심이다.
이번 공개는 로컬 하드웨어의 가속기를 끝까지 활용하면 성능이 어디까지 오르는지 보여 주는 실제 사례가 될 것으로 보인다. Apple 실리콘 칩을 단 맥 사용자와 AI 개발자에게는 로컬 추론 성능을 가늠할 새 기준이 생긴 셈이다.
Perplexity, Apple 실리콘 전용 엔진 Lily 오픈소스 공개
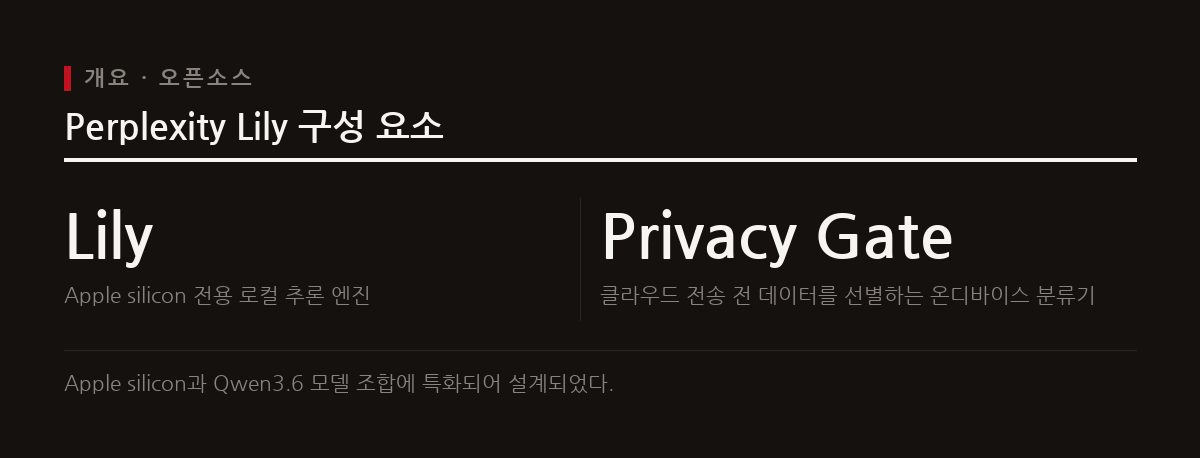
Perplexity는 자사 하이브리드 컴퓨팅(Hybrid Compute) 구조의 바닥을 받치는 로컬 추론 엔진 Lily를 오픈소스로 공개했다. Lily는 범용 추론 엔진이 아니다. 처음부터 특정 대상에 맞춰 최적화하도록 설계됐다. 구체적으로는 Qwen3.6-35B-A3B 모델과 Apple 실리콘 하드웨어라는 한 가지 조합에서 최대 성능을 내는 데 집중한다.
데이터 프라이버시 문제도 함께 다뤘다. Perplexity는 Lily와 함께 온디바이스에서 돌아가는 분류기인 프라이버시 게이트(Privacy Gate)를 내놓았다. 프라이버시 게이트는 사용자 데이터가 클라우드로 넘어가기 전에 기기 안에서 민감한 정보를 먼저 걸러 내 유출을 막는다.
범용 프레임워크를 배제한 Rust 및 Metal 스택 구축
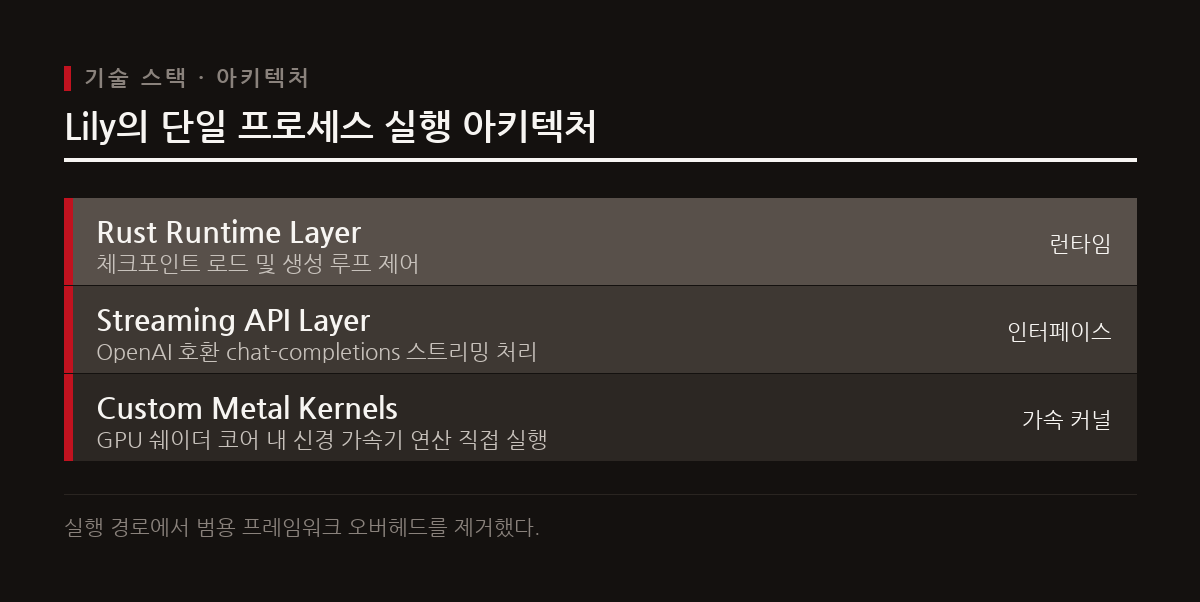
Lily의 가장 큰 기술적 특징은 실행 경로에서 PyTorch나 MLX 같은 범용 머신러닝 프레임워크를 아예 뺐다는 점이다. 범용 프레임워크의 추상화 계층은 여러 환경을 지원하는 데는 유리하지만, 특정 하드웨어의 성능을 끝까지 끌어내는 데는 방해가 되기도 한다. Lily는 이 계층을 없애고 Rust 단일 프로세스 런타임과 직접 작성한 커스텀 Metal 커널만으로 스택을 꾸렸다.
Rust 런타임은 컴파일 시점의 메모리 안전성과 제로 비용 추상화를 갖추고 있고, 파이썬의 전역 인터프리터 락(GIL) 같은 제약 없이 병렬 처리를 할 수 있어 모델 로드와 토큰 생성 루프가 가볍게 돈다. 연산을 맡는 Metal 커널은 Apple 실리콘 GPU 안의 신경 가속기(neural accelerator)를 직접 제어한다. M5 칩 계열의 신경 가속기는 대형 언어 모델의 프롬프트 처리에 맞춰져 있어, 저수준 API인 Metal로 연산 경로를 직접 다루면 지연 시간을 줄일 수 있다.
M5 Max 환경에서 MLX-LM 대비 향상된 토큰 처리 속도
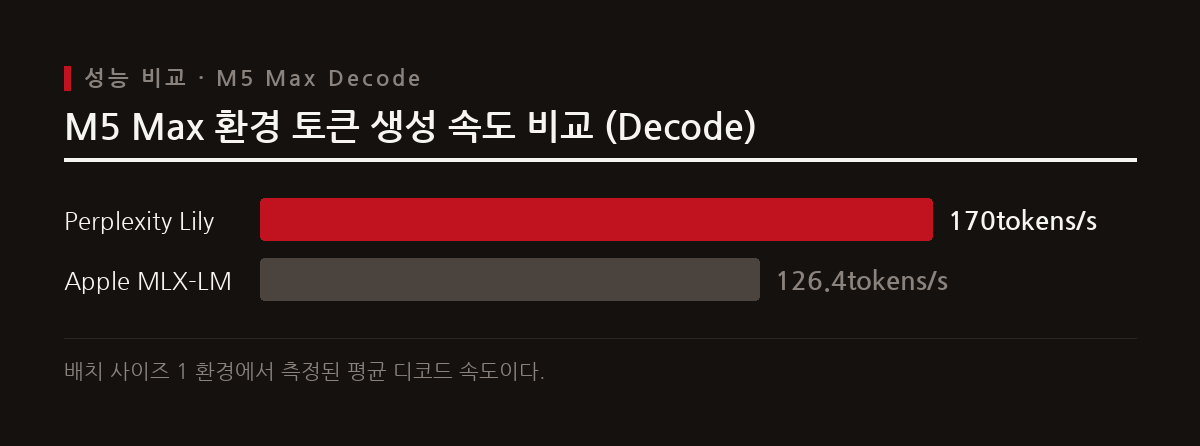
벤치마크 결과를 보면 차이가 분명하다. 40코어 GPU와 128GB 통합 메모리를 갖춘 Apple M5 Max에서 Qwen3.6-35B-A3B 모델을 돌렸을 때, Lily는 Apple이 직접 만든 MLX-LM보다 빨랐다. 256토큰부터 128,000토큰까지 여러 콘텍스트 길이에서 모두 앞섰다.
프롬프트 처리(Prefill)에서 Lily는 초당 4,156토큰을 처리해 초당 3,388토큰인 MLX-LM보다 약 1.23배 빨랐다. 토큰 생성(Decode) 속도는 초당 170.0토큰으로, 초당 126.4토큰인 MLX-LM의 약 1.35배였다. 로컬에서 큰 모델을 돌릴 때 사용자가 느끼는 응답 속도가 그만큼 빨라진다는 뜻이다.
출력 품질을 유지하며 달성한 극단적 최적화의 의의
속도만 빠르고 결과물 품질이 떨어지면 실무에 쓰기 어렵다. Lily는 이렇게 좁게 최적화하면서도 모델의 출력 품질을 잃지 않았다. MLX-LM과 교차 검증하려고 수행한 티처 포스트(teacher-forced) 검사에서 Lily의 퍼플렉서티(Perplexity) 편차는 MLX-LM 대비 0.04% 수준이었다.
두 엔진이 같은 상위 토큰을 고른 비율은 96.35%로, 답변 품질이 기능적으로 같은 수준임을 보여 줬다. 범용 프레임워크에 기대지 않고 특정 하드웨어와 모델에 바짝 맞추면 품질을 떨어뜨리지 않고도 성능을 크게 올릴 수 있다는 것이 이번 사례가 보여 준 결과다.
참고
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.