 유명한형제들
인공지능이 질문에 답하는 수준에서, 사용자의 복잡한 과업을 스스로 처리하는 에이전트 쪽으로 빠르게 옮겨 가고 있다. 오픈AI가 내놓은 GPT-6 Astra는 사람이 일일이 지시하지 않아도 장기 목표를 스스로 쪼개고 도구를 실행해 개발자들 사이에서 큰 화제가 됐다. 모델 하나로는 부족한 부분을 메우려고 외부 도구와 연결하는 오케스트레이션 아키텍처도 함께 중요해졌다. GPT-6 Astra의 작동 방식, 다른 모델과의 비교 수치, 실무 개발자가 아키텍처를 짤 때 생각할 점을 차례로 짚어 본다.
프롬프트 반응형을 넘어 자율 에이전트로
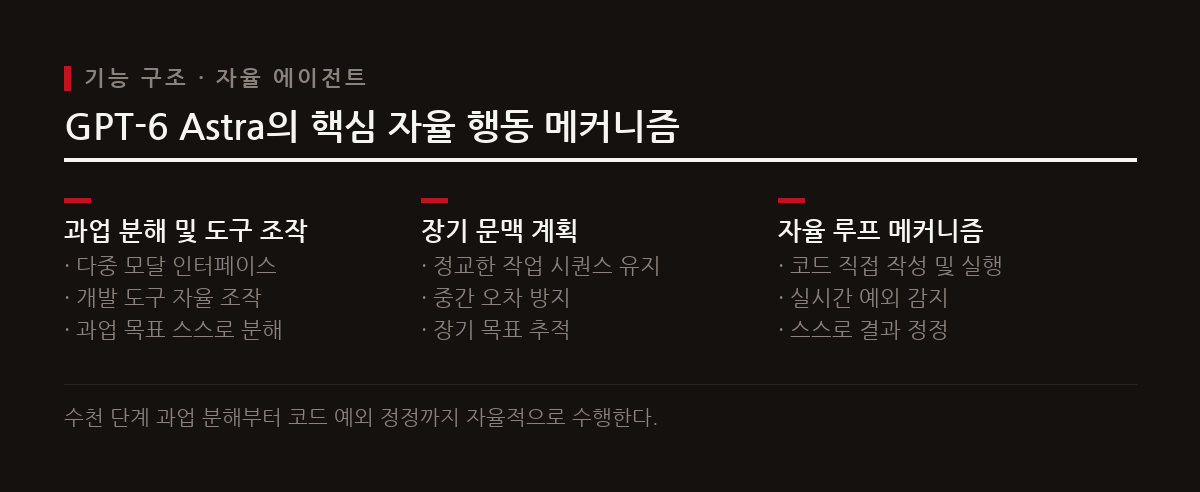
기존 대형 언어 모델은 사용자가 준 프롬프트에 맞춰 텍스트를 만드는 보조 역할에 머물렀다. GPT-6 Astra는 행동하는 수준이 다르다. 수천 단계에 이르는 복잡한 과업 목표를 스스로 나누고, 다중 모달 인터페이스와 개발 도구를 직접 조작해 최종 결과물까지 만들어 낸다. 스스로 움직이며 문제를 푸는 자율 행동 주체가 된 셈이다.
이런 자율성은 긴 문맥을 보고 계획을 세우는 능력에서 나온다. GPT-6 Astra는 오래 이어지는 정교한 작업 순서를 중간에 어긋나지 않게 끝까지 안정적으로 제어한다. 개발 중에 생기는 여러 예외 상황에도 유연하게 대응한다.
이 모델은 코드를 직접 짜서 실행하고, 실행 결과에 예외가 생기면 실시간으로 찾아내 고치는 자율 루프를 안에 갖추고 있다. 덕분에 사람이 손대기를 기다리지 않고 피드백 루프를 스스로 돌며 가장 나은 결과물을 완성해 간다.
LLM 오케스트레이션과 에이전트의 구조
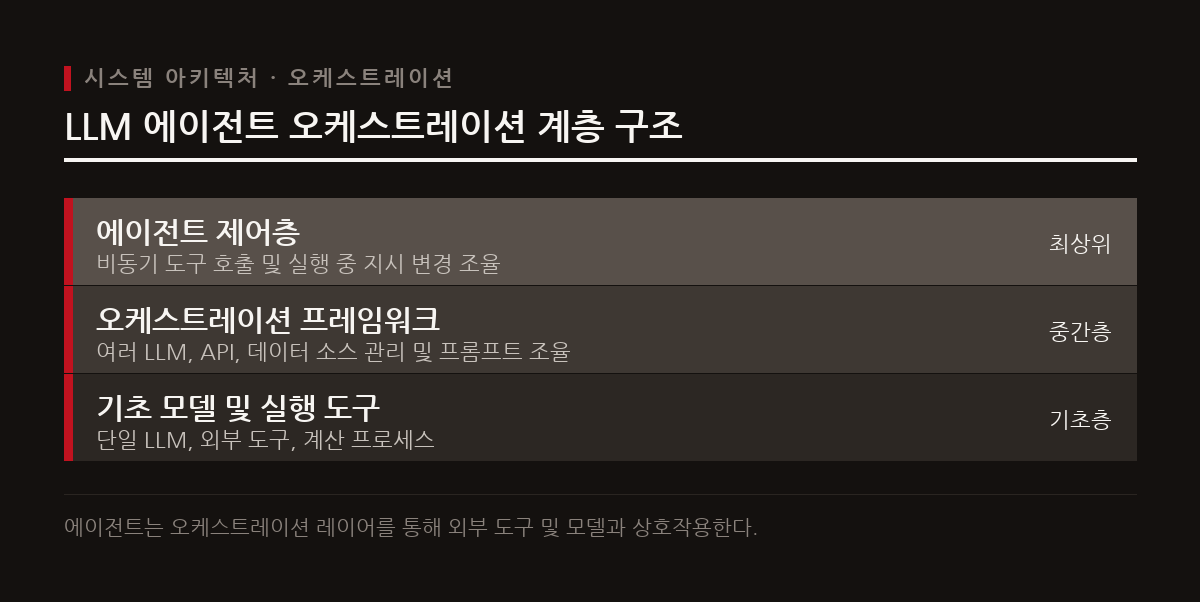
LLM 하나만으로는 크고 복잡한 상용 서비스를 온전히 만들기 어렵다. 그래서 여러 대형 언어 모델과 외부 도구, API, 데이터 소스를 한데 묶어 관리하고 연결하는 LLM 오케스트레이션 아키텍처가 필수가 됐다. 오케스트레이션은 각 모델의 강점을 살리면서 시스템 전체의 효율을 지키는 중심축이다.
AI 에이전트는 이런 오케스트레이션 프레임워크 위에 만들어지고, 복잡한 연속 업무를 처리하기 위한 여러 기능을 쓴다. 비동기 도구 호출, 그리고 작업 도중에 실시간으로 지시를 바꾸는 미드턴 스티어링 기능 덕분에 에이전트는 멈추지 않고 작업을 끝낼 수 있다.
개발자가 아래 계층의 오케스트레이션 아키텍처를 안정적으로 설계해 두면 그 위에 더 나은 AI 에이전트 서비스를 올릴 수 있다. 여러 프레임워크가 맞물려 돌아가도록 조율하는 이 계층이 실제 비즈니스 로직을 자동화하는 바탕이 된다.
주요 AI 모델 비교와 토큰 효율성
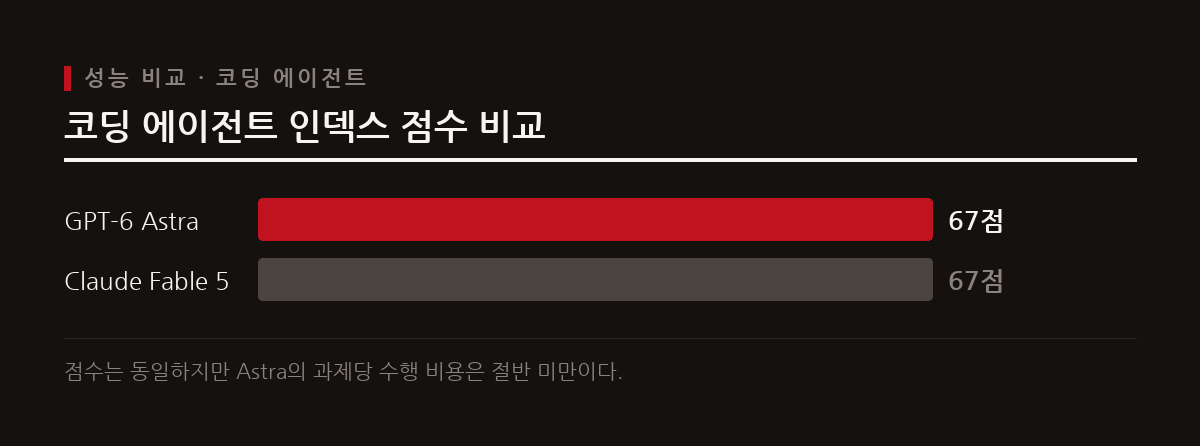
GPT-6 Astra는 코딩 성능과 비용 양쪽에서 좋은 결과를 냈다. 코딩 에이전트 인덱스에서 Anthropic의 Claude Fable 5와 같은 67점을 받았는데, 실제 과제 1건당 드는 비용은 Fable 5의 절반이 안 돼 가격 경쟁력이 뛰어나다.
길고 복잡한 지식 작업 능력을 보는 AA-브리프케이스 평가에서도 점수가 눈에 띄게 올랐다. GPT-6 Astra는 이전 세대인 GPT-5.6 Sol보다 평가 점수가 80 Elo 포인트 높아, 지식 추론 능력이 나아졌음을 보여 줬다.
차이가 가장 큰 쪽은 토큰 효율이다. 최대 추론 강도로 코덱스를 쓸 때 GPT-6 Astra가 쓰는 토큰은 GPT-5.6 Sol의 3분의 1 수준이고, Claude Opus 5와 비교하면 7분의 1 수준이다. 성능 평가 기관 아티피셜애널리시스의 조사에서도 GPT-6 Astra의 토큰 사용량은 GPT-5.6 Sol보다 약 70% 적어, 인프라 비용 부담이 크게 줄어든다.
공개 벤치마크 및 영역별 비교
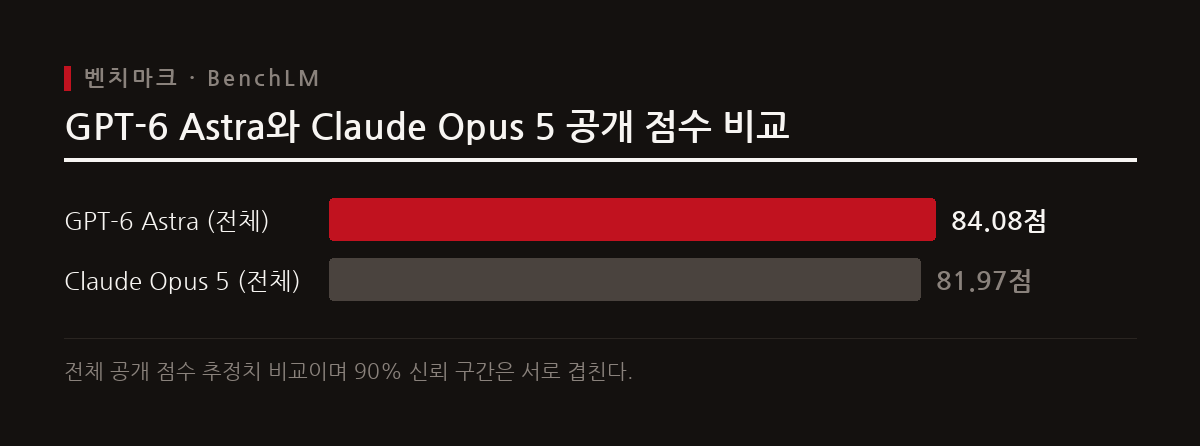
벤치마크를 종합해 보면 전체 공개 점수와 영역별 성능에서 강점이 조금씩 갈린다. 전체 공개 점수 추정치는 GPT-6 Astra가 84.08점으로 Claude Opus 5의 81.97점보다 높다. 문맥 이해와 지식 처리를 종합하면 Astra가 근소하게 앞서는 셈이다.
공개 코딩 부문은 양상이 반대다. Claude Opus 5가 정확도 75.8%로 74.6%를 기록한 GPT-6 Astra를 근소하게 앞섰다. 코딩 알고리즘 구현의 완성도에서는 Opus 5도 여전히 경쟁력이 강하다.
다만 두 항목 모두 90% 신뢰 구간이 서로 겹친다. 어느 한쪽이 확실히 낫다고 결론 내리기보다는 경향 정도로 강점을 읽고, 프로젝트마다 요구 사항에 맞는 모델을 신중하게 골라야 한다.
실무 개발자를 위한 도입 시사점
GPT-6 Astra의 자율 루프와 토큰 효율은 실무 개발자에게 애플리케이션 아키텍처를 새로 설계하라고 요구한다. 프롬프트를 넣고 결과를 받는 파이프라인 대신, 스스로 오류를 고치고 도구를 직접 다루는 에이전트 시스템을 설계할 수 있게 된 만큼 비동기 조율에 강한 인프라가 필요하다.
토큰 소비가 크게 줄어 같은 예산으로 전보다 훨씬 길고 정교한 워크플로우를 돌릴 수 있게 됐다. 비용 때문에 도입을 미뤄 두었던 연속 태스크 파이프라인을 실제 프로덕션 환경에 더 적극적으로 배포해 볼 만하다.
모델 하나에 기대기보다 모델마다 잘하는 일을 맡기는 멀티 모델 전략이 필요하다. 코딩처럼 정밀함이 필요한 작업과 대규모 워크플로우를 돌리는 오케스트레이션 요구 사항을 나눠 정리하고, 각 자리에 맞는 모델을 배치하는 유연함이 자율 에이전트 개발에서 경쟁력이 된다.
참고
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.