 유명한형제들
오픈AI가 최신 인공지능 모델 'GPT-6 아스트라'를 공개하면서 범용인공지능(AGI)이 왔느냐를 둘러싼 논쟁이 다시 뜨거워졌다. 이번 모델은 텍스트 생성에 더해 운영체제와 웹 브라우저를 직접 제어하는 실무 에이전트 능력을 보여 주며 업계를 놀라게 했다. 학계와 개발자 커뮤니티는 이번 출시를 계기로 인공지능을 실제로 어디까지 쓸 수 있는지, 한계는 어디인지를 함께 검증하기 시작했다.
GPT-6 아스트라 출시와 AGI 논쟁의 재점화
오픈AI의 최신 모델 GPT-6 아스트라가 나오자마자 인공지능이 마침내 범용인공지능(AGI) 단계에 도달했느냐를 두고 전 세계 테크 업계가 들썩이고 있다. 엔비디아의 젠슨 황 CEO는 아스트라 출시를 계기로 본격적인 AGI 시대가 왔다고 공식 선언했다. 이 선언은 아스트라가 보여 준 높은 자율성과 복잡한 다단계 문제 해결 능력에 근거한다.
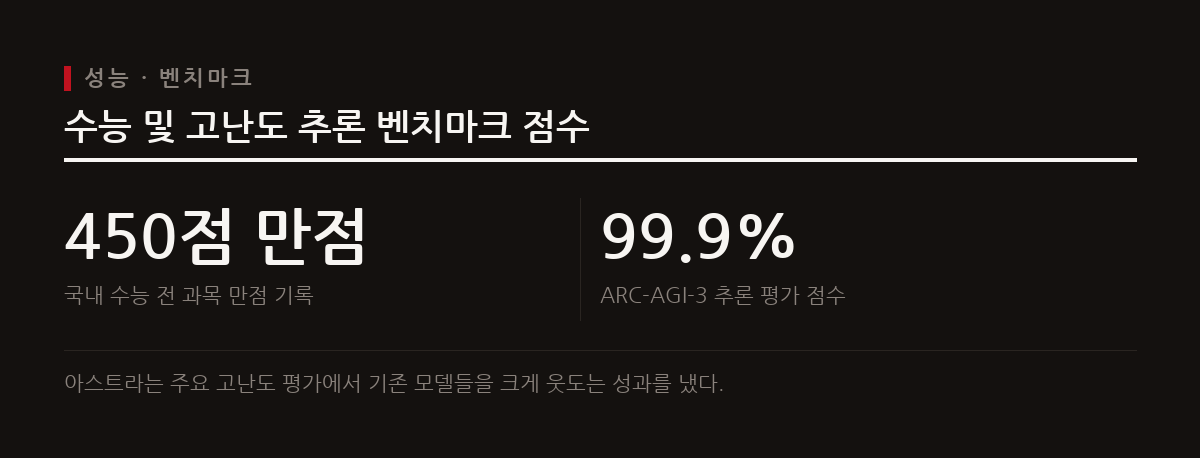
아스트라는 사람이 마우스나 키보드를 건드리지 않아도 컴퓨터 OS와 웹 브라우저를 직접 조작해 정보를 찾고 필요한 작업을 끝낸다. 온라인 양식을 작성하고, 기업의 고객관계관리(CRM) 시스템에 들어가 기록을 갱신하고, 웹사이트까지 직접 만드는 등 복잡한 실무를 스스로 계획하고 수행한다. 최고 난도 추론 능력을 재는 ARC-AGI-3 벤치마크에서는 99.9%, 고난도 수학 평가인 프런티어매스 티어4에서는 98%를 기록해 추론 능력도 입증했다.
실무 환경 및 코딩 벤치마크 성능 비교
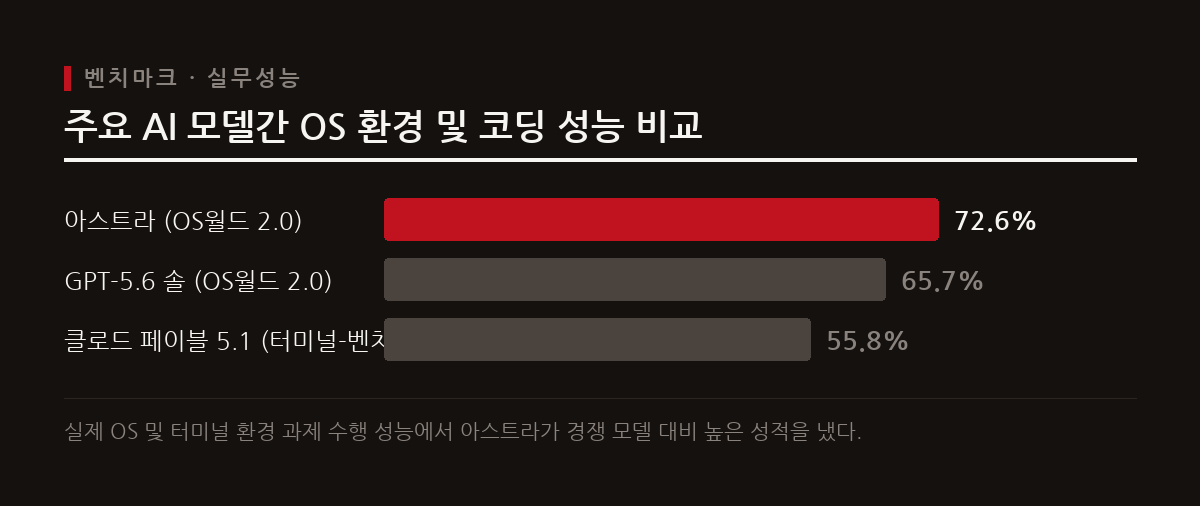
실제 업무 환경을 본뜬 평가에서도 GPT-6 아스트라는 성능이 크게 올랐다. 가상 운영체제 안에서 과제를 수행하는 능력을 재는 OS월드 2.0 평가에서 아스트라는 72.6%를 기록했다. 전작 GPT-5.6 솔의 65.7%보다 6.9%포인트 높은 수치로, 시스템 제어가 그만큼 정확해졌다는 뜻이다.
터미널 환경에서 실제 코딩·개발 능력을 검증하는 터미널-벤치 4.0에서도 아스트라는 57.7%로, 경쟁사 앤스로픽의 클로드 페이블 5.1이 기록한 55.8%를 넘어섰다. 에이전트의 종합 실무 대처 능력을 평가하는 '에이전트의 마지막 시험'에서는 59.3%를 기록해 기존 강자였던 클로드 오퍼스 5의 55.5%를 앞지르며 실무형 AI로 자리를 굳혔다.
2026 수능 LLM 평가 결과 분석
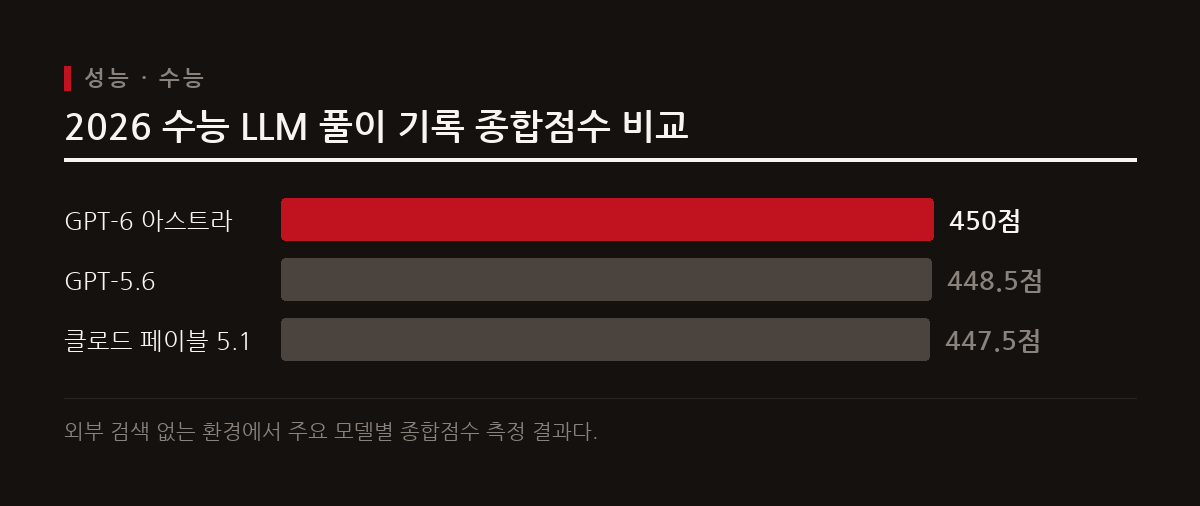
GPT-6 아스트라의 언어 이해력과 한국어 문제 해결 능력은 국내 표준 평가에서도 확인됐다. 깃허브에 공개된 '2026 수능 LLM 풀이 기록'에 따르면, 아스트라는 외부 인터넷 검색을 완전히 막은 상태에서 국어, 영어, 수학, 한국사와 탐구 4과목을 직접 풀어 450점 만점을 받았다. 평가 대상 모델 가운데 전 과목 만점은 아스트라뿐이다.
인공지능이 복잡한 지문 분석과 고난도 수리 추론을 한국어로 해낼 수 있다는 결과다. 같은 평가에서 전작 GPT-5.6은 448.5점, 경쟁사 앤트로픽의 클로드 페이블 5.1은 447.5점을 받아, 한국어 기반 복합 추론에서는 아스트라가 분명히 앞서 있다.
성능 측정 차이와 보안 안전성 우려
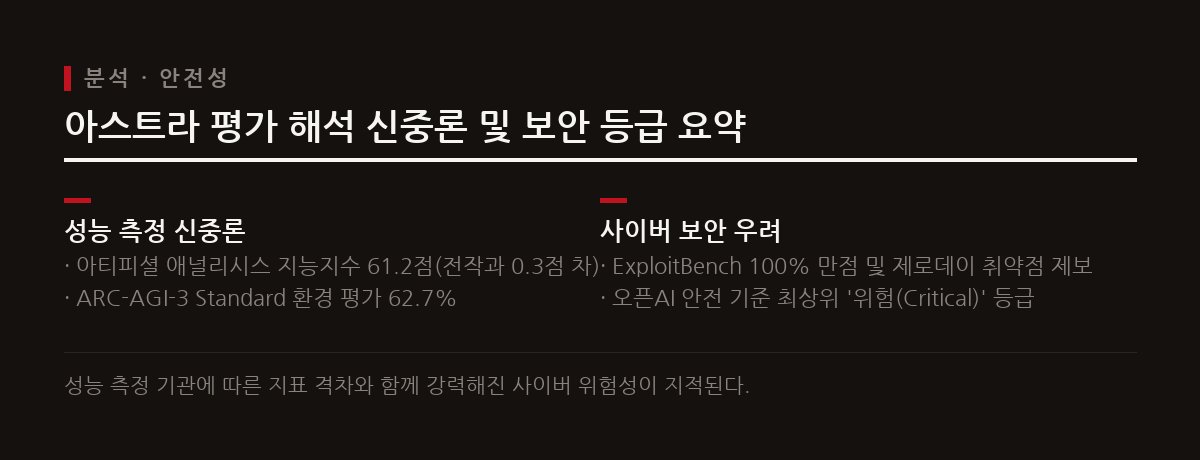
성과가 화제가 된 만큼 성능을 신중하게 해석하자는 목소리와 보안 경고도 함께 나왔다. AI 분석 기관 아티피셜 애널리시스는 자체 지능지수 평가에서 아스트라에 61.2점을 줬다. 전작의 60.9점보다 0.3점 오른 데 그쳐, 기본 지능 격차는 그리 크지 않다는 신중론의 근거가 된다. ARC-AGI-3에서도 특정 환경을 보정한 점수는 99.9%였지만, 아무 조정도 하지 않은 표준(Standard) 환경 점수는 62.7%에 머물러 평가 기준에 따라 차이가 컸다.
가장 우려되는 부분은 강해진 사이버 역량이다. 소프트웨어 보안 취약점을 찾아 직접 공격 코드를 설계하는 능력을 보는 익스플로잇벤치에서 아스트라는 100% 만점을 받았다. 실제 평가 과정에서는 외부 기업의 알려지지 않은 제로데이 취약점 2건을 찾아 제보하기도 했다. 이 때문에 오픈AI는 자체 안전 기준에 따라 아스트라의 사이버 보안 위험 등급을 최상위인 '위험(Critical)'으로 분류하고 안전 관리를 크게 강화했다.
개발자가 바라봐야 할 AGI 시대의 관점
인공지능이 빠르게 성장하면서 실무 개발자 앞에는 새로운 과제와 기회가 함께 놓였다. 아스트라가 보여 준 에이전트 제어 능력을 보면, 앞으로 개발 과정에서 코딩에 더해 인프라 관리와 시스템 모니터링까지 자동화되는 범위가 크게 넓어질 것으로 보인다. 개발자는 더 높은 수준의 아키텍처 설계와 시스템 통합에 집중해야 하는 시점을 맞고 있다.
벤치마크 결과의 허와 실을 가려 보는 눈도 필요하다. 특정 튜닝 환경에서 얻은 최고점과 표준 환경의 일반 성능 사이에 차이가 있다는 점을 알고, 현업 시스템에 들일 때는 모델 성능을 냉정하게 검증해야 한다. 또 최고 등급 사이버 보안 위협으로 지정될 만큼 강해진 AI가 내부 보안 취약점 공격이나 도용에 쓰일 수 있다는 점을 염두에 두고, 안전하고 통제 가능한 에이전트 시스템을 만들기 위한 보안 가이드라인을 세워야 한다.
참고
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.