 유명한형제들
AI 코드 생성 기술은 이제 사람이 한 줄씩 다 이해하기 어려운 고성능 저수준 커널 코드까지 스스로 짜는 단계에 왔다. 예전에는 고성능 프로그래밍에서 엔지니어가 손으로 최적화하는 일이 꼭 필요했지만, 지금은 기계가 최적화한 코드가 성능과 안정성을 함께 챙기는 표준으로 떠오르고 있다. OpenAI의 Gluon 커널과 DeepSeek의 MLA 커널 사례는 코드를 평가하는 기준을 사람이 읽기 쉬운지에서 자동으로 검증할 수 있는지로 빠르게 옮겨 놓고 있다.
AI 커널 개발의 패러다임 전환
AI 코드 생성은 고수준 언어에서 출발해 어셈블리에 가까운 정밀한 저수준 커널 작성으로 빠르게 넓어지고 있다. OpenAI의 Gluon 커널과 DeepSeek의 MLA(Multi-Layer Attention) 커널은 기계 최적화에 맞춘 새로운 저수준 프로그래밍 방식을 보여주는 대표 사례다. 소프트웨어 설계의 무게중심이 사람이 읽기 쉬운 코드에서 성능과 실행 가능성을 기준으로 한 기계적 최적화로 옮겨가고 있다.
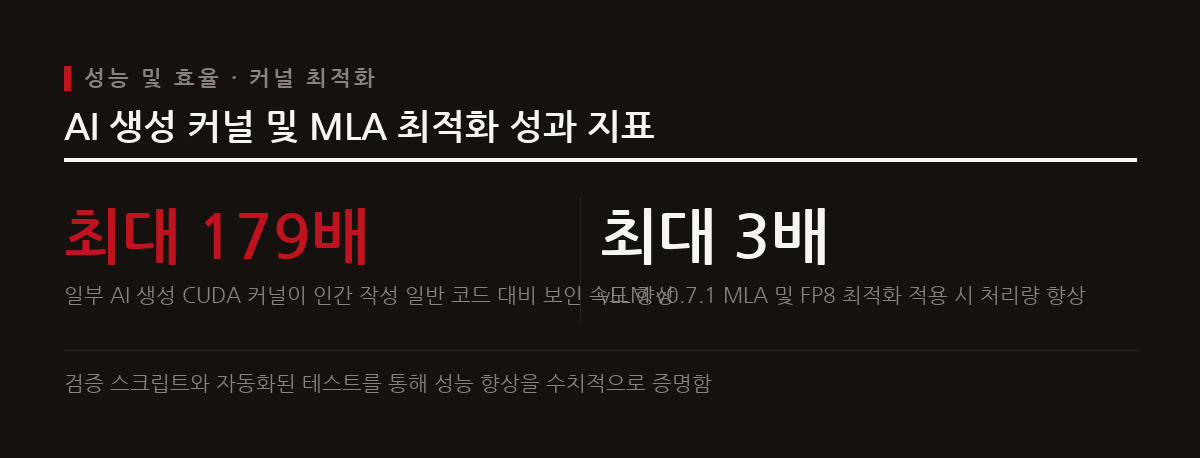
일부 하드웨어 최적화 연구에서는 AI가 생성한 특정 CUDA 커널이 사람이 작성한 일반 코드보다 최대 179배 빠르게 실행됐다. 고성능 커널 개발의 목표가 코드 한 줄 한 줄을 사람이 완전히 이해하는 것보다 기계 수준의 검증과 실제 성능으로 바뀌는 이유가 여기에 있다. 엔지니어가 개별 명령어를 분석하지 못하더라도 자동화된 검증 프레임워크가 정상 동작을 보증하면, 기계가 짠 복잡한 연산 코드도 곧바로 프로덕션에 투입할 수 있다.
OpenAI Gluon과 AI 생성 어셈블리
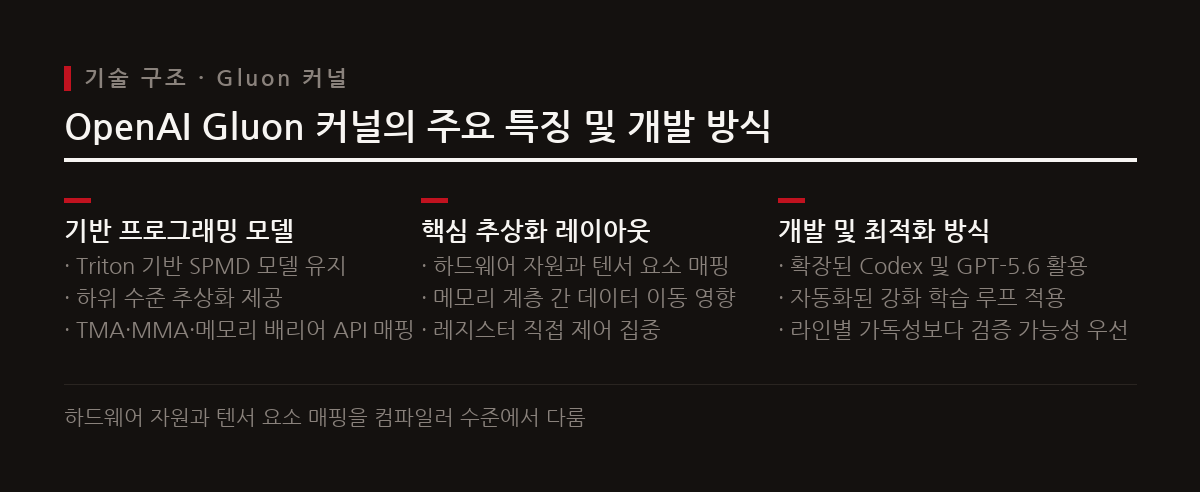
OpenAI가 만든 저수준 커널 프로그래밍 언어 Gluon은 사람이 읽고 쓰기 쉬운 직관성을 내주는 대신, 하드웨어 레지스터와 물리적인 데이터 이동 경로를 직접 제어하는 데 집중하도록 설계됐다. Triton 위에 만들어진 Gluon은 Triton의 단일 프로그램 다중 데이터(SPMD) 프로그래밍 모델을 그대로 따르면서, 그보다 훨씬 낮은 수준의 하드웨어 제어 추상화를 지원한다. 엔비디아 GPU에서는 텐서 메모리 가속(TMA), 행렬 곱셈-덧셈(MMA), 메모리 배리어 같은 하드웨어 제어 명령어에 직접 대응하는 API를 제공한다.
SemiAnalysis의 애널리스트 조던 나노스(Jordan Nanos)에 따르면, OpenAI 엔지니어들은 스크롤하며 보는 커널 코드의 각 줄이 정확히 무슨 일을 하는지 다 알지는 못한다. 그런데도 성능과 신뢰성을 확보할 수 있는 것은 GPT-5.6 같은 차세대 AI 모델이 Triton과 Gluon 기반의 고성능 커널을 직접 작성하고 고치도록 훈련됐기 때문이다. 조던 나노스는 이렇게 복잡하지만 제대로 작동하는 코드를 두고 본질적으로 Gluon 환경에 직접 던져진 AI 생성 어셈블리라고 정의했다. 사람이 해석하기는 어려워도 오차 없이 실행되므로 쓰레기 코드는 아니라는 평가다.
DeepSeek FlashMLA의 구조적 혁신
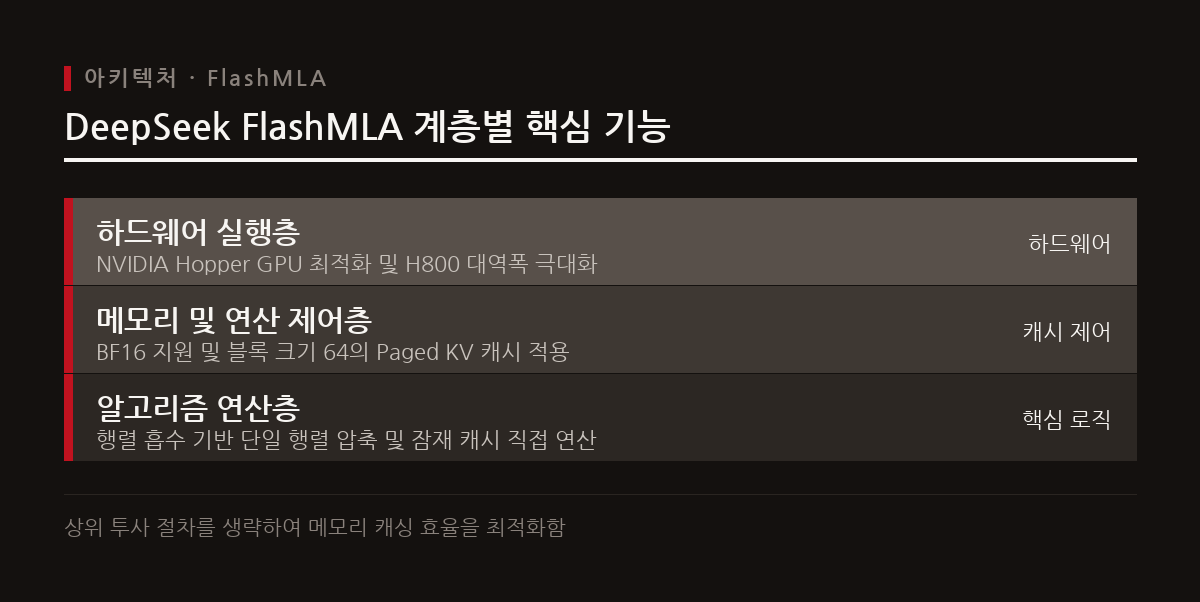
DeepSeek이 오픈소스로 공개한 FlashMLA는 하드웨어 성능을 한계까지 끌어내 메모리 대역폭 병목을 해결한 디코딩 커널이다. 엔비디아 Hopper GPU 아키텍처에 맞춰 설계됐고, 반정밀도 부동소수점(BF16) 데이터 포맷과 블록 크기 64 기반의 페이지드 KV 캐시를 기본으로 지원해 가변 길이 시퀀스를 계산할 때의 비효율을 크게 줄였다. 메모리 자원이 제한된 상황에서 거대 언어 모델의 추론 효율을 높이는 데 핵심 역할을 한다.
구조의 핵심은 DeepSeek V2 논문에서 입증된 행렬 흡수 알고리즘이다. 일반적인 어텐션 기법은 두 개의 중간 행렬을 따로 캐싱해 메모리를 낭비하지만, FlashMLA는 입력 행렬을 단일 행렬로 바로 압축한 뒤 추론 시점에 잠재 캐시 값에서 직접 계산한다. 이 방식 덕분에 vLLM v0.7.1에 적용된 MLA 및 FP8 최적화는 모델 처리량을 최대 3배로 늘렸고, 동시에 수용할 수 있는 메모리 용량도 최대 10배로 키웠다. 고성능 연산이 필요한 H800 GPU 환경에서는 메모리 대역폭을 끝까지 활용해 최대 3000 GB/s의 처리 속도를 냈다.
커널 최적화 프로세스의 전환
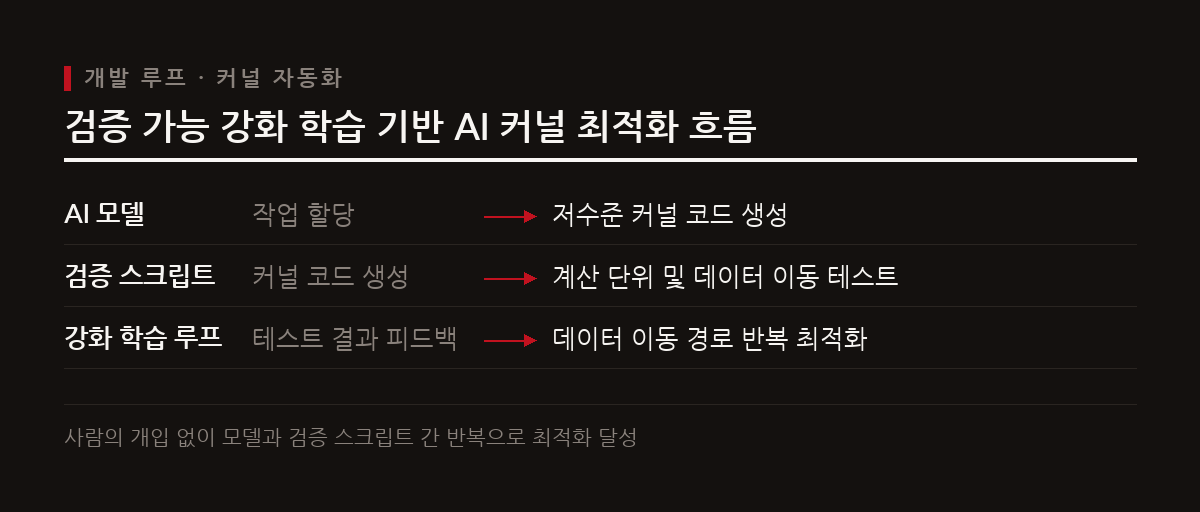
예전에는 숙련된 개발자가 라이브러리를 써서 커널을 하드코딩으로 직접 미세 조정하는 것이 고성능을 내는 유일한 방법이었다. 요즘 커널 최적화는 검증 시스템과 연결된 자동 강화 학습 루프로 빠르게 바뀌고 있다. AI 시스템은 작업을 받으면 자동으로 테스트를 돌리고, 데이터 이동 제어와 복잡한 계산 단위를 스스로 반복 수정하면서 가장 좋은 결과를 찾아낸다.
이런 자동화 루프로 만든 순수 CUDA-C 코드는 CUTLASS나 Triton 같은 주류 라이브러리 없이도 기존 PyTorch의 전문가 최적화 프로덕션 커널과 비슷하거나 더 나은 성능을 내고 있다. 개발 현장에서 코드를 평가하는 기준도 사람이 읽고 유지보수하기 쉬운지에서 바뀌고 있다. 기계 안에서 오차 없이 얼마나 최적화되는지, 그리고 자동화 스크립트로 얼마나 빨리 정확성을 입증할 수 있는지가 새로운 기준이 되고 있다.
AI 생성 코드 시대의 개발자 역할
사람이 해독하기 어려울 만큼 추상화되고 최적화된 기계 생성 커널을 프로덕션에 안심하고 올리려면 결함을 걸러낼 철저한 자동화 테스트 체계가 먼저 갖춰져야 한다. 코드를 한 줄씩 직접 쓰고 레지스터 배치를 고민하는 저수준 작업은 점점 지능형 에이전트의 몫이 된다. 소프트웨어 엔지니어가 가치를 만드는 방식도 그만큼 크게 바뀌고 있다.
앞으로 개발자는 저수준 루프를 직접 하드코딩하기보다, AI가 쏟아내는 최적화 커널이 정해진 범위 안에서 안전하게 작동하도록 자동 검증 파이프라인과 모니터링 시스템을 설계하는 조율자 역할을 맡게 된다. AI 생성 코드 시대에는 국소적인 구현 능력보다 전체 아키텍처의 확장성을 고려하는 시스템 엔지니어링 역량과, 결함을 미리 막는 품질 보증 설계 능력이 개발자의 경쟁력이 될 것이다.
참고
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.