 유명한형제들
대규모 언어 모델을 개인 로컬 기기에서 돌릴 때 가장 먼저 막히는 것은 메모리 용량이다. 희소 전문가 혼합(MoE) 아키텍처는 연산 효율이 좋지만 수십 기가바이트의 메모리를 요구해 일반 데스크톱이나 노트북에서는 실행하기 어렵다. Apache-2.0 라이선스로 공개된 오픈소스 프레임워크 Edge0는 모델 가중치를 전부 메모리에 올리지 않고, 필요한 전문가 가중치만 SSD에서 실시간으로 스트리밍해 연산한다. 이 방식으로 35B 파라미터급 MoE 모델을 2.9GB 안팎의 피크 활성 메모리로 실행한다.
Edge0: 로컬 기기 MoE 구동의 새 기준
Edge0는 Apache-2.0 라이선스로 개발된 오픈소스 AI 스트리밍 추론 프레임워크다. 목표는 대규모 희소 전문가 혼합(MoE) 모델을 서버용 GPU 없이 일반 데스크톱이나 노트북 같은 개인 기기에서 돌리는 것이다.
기존 프레임워크는 추론하려면 모델 전체 가중치를 통합 메모리(RAM)에 올려 두어야 했다. Edge0는 전체 가중치를 RAM에 올리지 않고 mmap 방식으로 추론 시점에 필요한 전문가 가중치만 SSD에서 읽어 와 연산한다. 그래서 메모리가 빠듯한 로컬 환경에서도 초대형 모델을 구동할 수 있다.
Edge0의 3가지 핵심 기술 구성
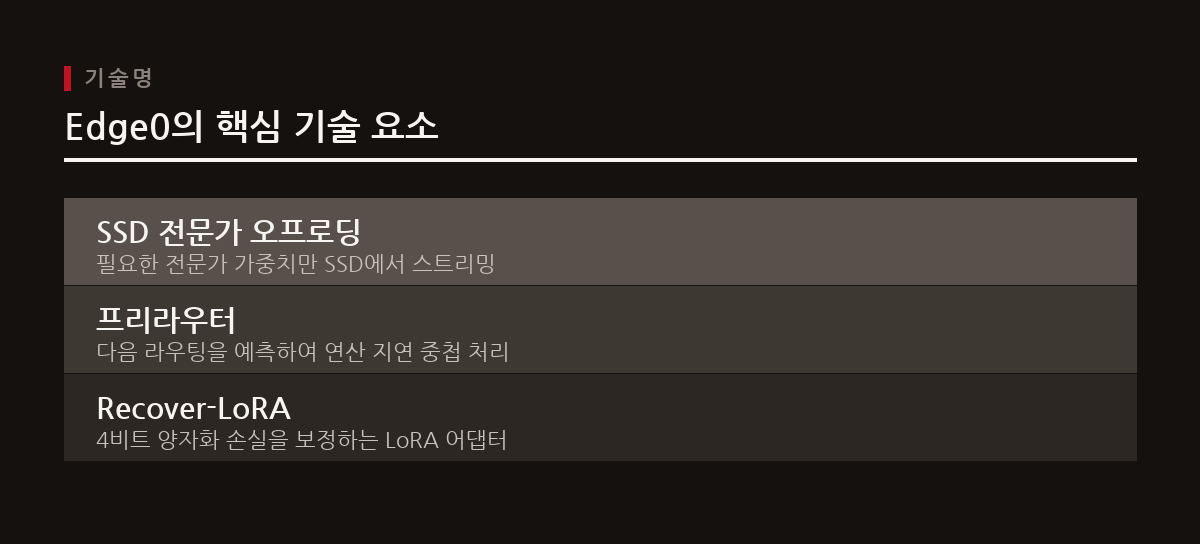
Edge0는 SSD 전문가 오프로딩, 프리라우터, Recover-LoRA 세 가지 기술을 묶어 MoE 모델의 메모리 사용량을 줄이고 추론 속도를 끌어올린다. 첫 번째인 SSD 전문가 오프로딩(SSD Expert Offload)은 토큰마다 활성화되는 소수의 전문가 가중치만 디스크에서 메모리로 불러온다. 덕분에 피크 메모리 사용량이 전체 모델 파라미터 용량이 아니라 실제 연산에 쓰이는 활성 파라미터 집합 크기 수준으로 내려간다.
두 번째인 프리라우터(Prerouter)는 다음 레이어의 라우팅 결정을 1스텝 앞서 예측하는 별도의 헤드다. 이 예측 덕분에 스토리지 읽기와 GPU 연산을 겹쳐 처리할 수 있어 디스크 읽기를 기다리는 지연이 크게 준다. 세 번째인 Recover-LoRA는 4비트 양자화와 라우팅 근사 과정에서 생기는 정확도 손실을 보정하는 어댑터다. FP 풀프레시전 교사 모델에서 증류 학습한 비통합 LoRA 어댑터를 얹어 양자화로 떨어진 모델 품질을 메운다.
35B급 모델을 3GB 이하 메모리로
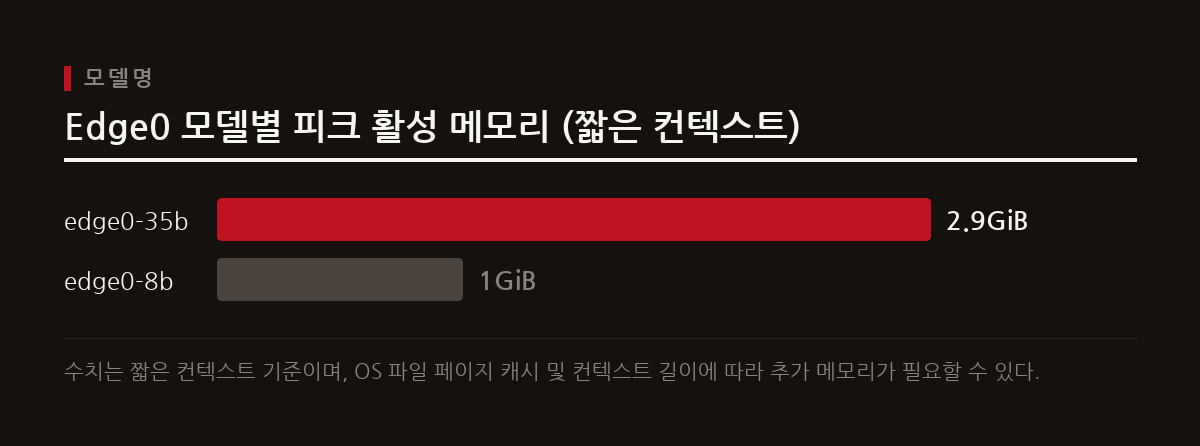
edge0-35b 모델은 짧은 컨텍스트에서 약 2.9 GiB(약 2.9GB)의 피크 활성 메모리만 쓴다. 35B급 모델을 흔한 로컬 기기에서 돌릴 수 있는 수준이다. 경량 티어인 edge0-8b는 짧은 컨텍스트에서 약 1.0 GiB를 쓰고, 3.3k 토큰 컨텍스트에서도 피크 활성 메모리가 3.3 GiB 수준이다.
속도도 쓸 만하다. 24GB 메모리를 갖춘 Mac mini M4 Pro에서 edge0-35b는 14.9~17.7 tok/s의 디코드 속도를 기록했다. 같은 기기에서 3.3k 토큰 프롬프트 기준 콜드·웜 프리필 처리량은 각각 113 tok/s, 140 tok/s였다. 메모리가 제한된 환경이라는 점을 생각하면 응답 속도가 충분히 나온다.
최적화된 MoE 아키텍처와 성능 향상
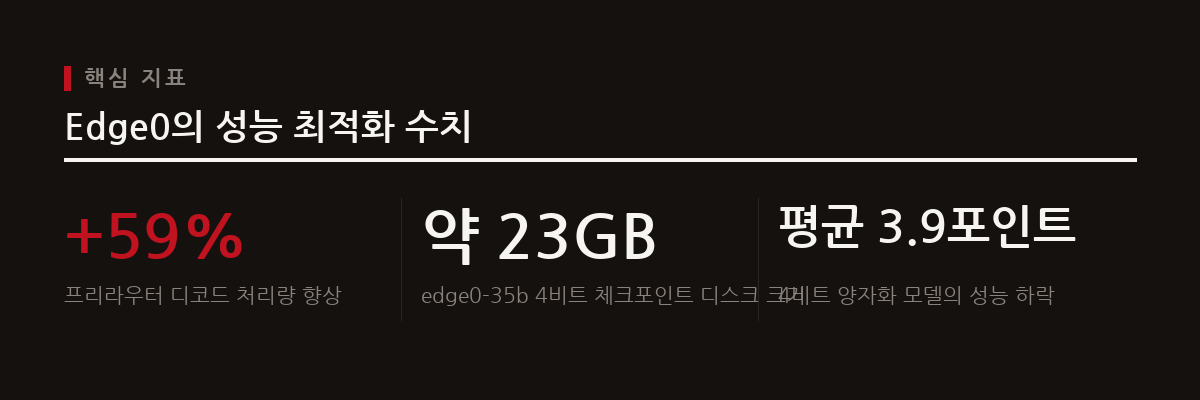
edge0-35b는 40개 레이어에 256개 전문가를 두고 토큰당 4개 전문가(K=4)를 활성화하는 희소 MoE 구조다. 4비트로 양자화한 체크포인트의 SSD 저장 용량은 edge0-35b가 약 23GB, edge0-8b가 약 4.2GB다.
Prerouter 헤드의 라우팅 예측은 SSD 페치와 계산을 겹쳐 디코드 처리량을 최대 59%까지 높인다. 4비트 양자화 모델은 FP16 원본보다 MMLU-Pro, HumanEval 등 OpenCompass 벤치마크에서 평균 3.9포인트 낮은 점수를 받았고, 증류 학습한 Recover-LoRA 어댑터가 이 손실의 일부를 되돌린다.
Edge0의 현재 한계 및 로드맵
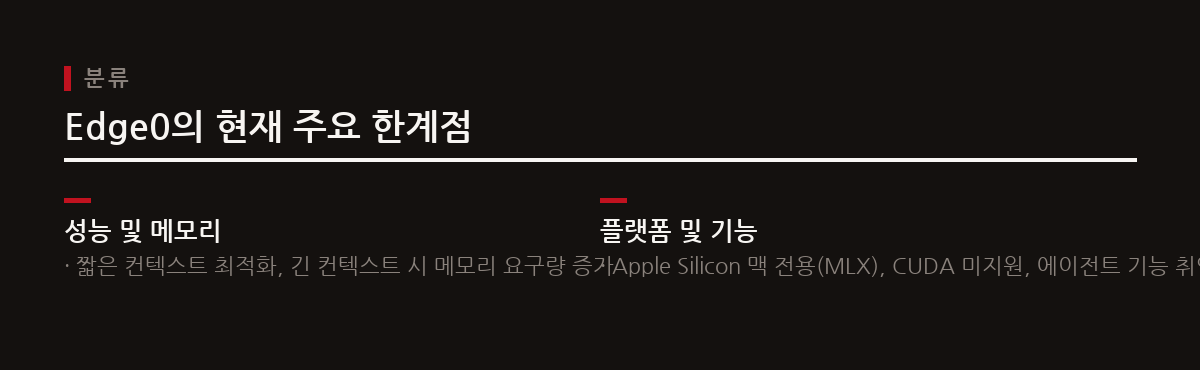
메모리 절감 폭은 크지만 한계도 있다. 2.9 GiB라는 활성 메모리 수치는 짧은 프롬프트와 짧은 컨텍스트 기준이다. 컨텍스트가 길어지면 KV 캐시가 늘고 OS 파일 페이지 캐시용 여유 공간도 필요해 메모리를 더 쓰며, 최대 컨텍스트까지 늘렸을 때의 한계 수치는 확인되지 않았다.
현재 배포판은 Apple Silicon 맥 전용 MLX 백엔드로만 구현되어 있고, CUDA 백엔드는 향후 로드맵에 들어 있다. 모바일 바이너리도 확인되지 않았다. 요청은 하나씩 직렬(FIFO)로 처리하며, 도구 사용이나 멀티스텝 에이전트 작업에는 약한 초기 프리뷰 단계다. MLX 백엔드를 실행하려면 Python 3.10 이상과 mlx==0.30.6, mlx-metal==0.30.6, mlx-lm==0.31.0 라이브러리가 필요하다.
온디바이스 AI 발전을 위한 Edge0의 역할
Edge0를 쓰면 고성능 인프라나 전용 클라우드 서버 없이 소비자용 개인 기기에서 35B급 AI 모델을 실행할 수 있다. 온디바이스 AI를 시도할 수 있는 사람이 그만큼 늘어난다.
개별 개발자도 비싼 GPU 서버를 마련하지 않고 대규모 MoE 모델을 시험하고 자기 애플리케이션에 배포해 볼 수 있다. 지금은 맥OS와 특정 백엔드 중심의 초기 단계지만, CUDA 지원과 모바일 기기 확장이 이뤄지면 개인화된 온디바이스 에이전트 개발이 더 빨라질 것이다.
참고
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.