인공지능 기술이 비약적으로 발전하고 있으나, 전 세계 모든 언어와 문화가 고르게 혜택을 받고 있지는 않다. 특히 영어 등 주요 언어 중심의 학습 데이터 편중 현상은 저자원 언어 환경에서 심각한 성능 저하로 이어지고 있다. 빌 게이츠를 비롯한 전문가들은 이러한 언어적 격차가 단순한 번역 오류를 넘어 생명과 직결되는 분야에서 치명적인 위험이 될 수 있다고 경고한다.
인공지능의 언어 격차 문제
빌 게이츠는 최신 인공지능이 영어 등 주요 언어에서는 능숙하지만 아프리카 토착어에서는 오류율이 약 10배나 더 높아진다고 지적했다. 그는 3백만 명이 사용하는 서아프리카 우바어를 예시로 들며 특정 언어 사용자들이 겪는 기술적 소외를 비판했다. 의료나 교육처럼 오차가 생명과 직결되는 분야에서 인공지능의 오류는 위험성이 크다. 성능 격차의 주된 원인은 아프리카 언어 학습 데이터의 부족과 언어적 소외이다.

아프리카 언어 벤치마크 성능 평가
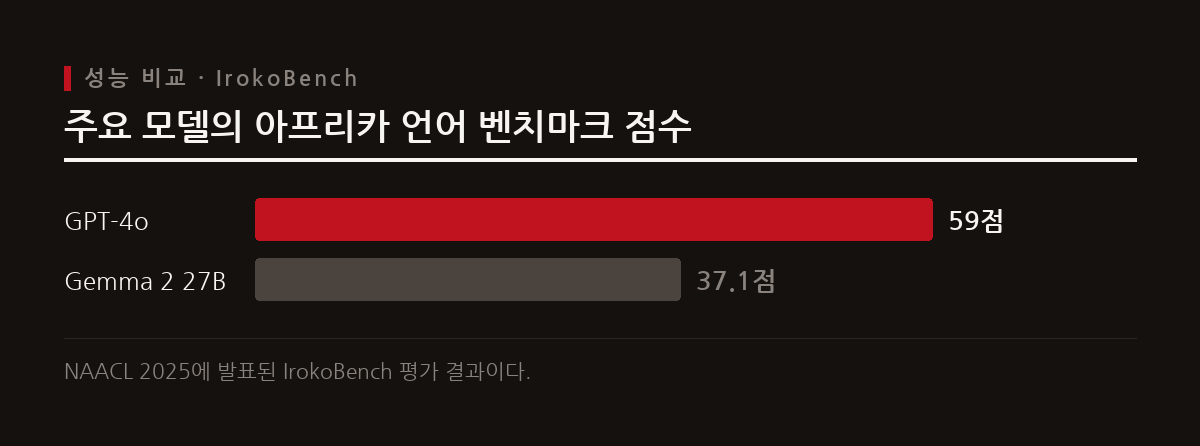
아프리카 언어 벤치마크인 IrokoBench 평가에서 GPT-4o는 59.0점, Gemma 2 27B는 37.1점을 기록하여 모델 간 격차를 보였다. 최고 성능의 폐쇄형 모델인 GPT-4o는 59.0점을 기록했다. 최고 성능의 개방형 모델인 Gemma 2 27B는 37.1점을 기록했다. 두 모델 사이에는 21.9점의 점수 차이가 존재한다. 이처럼 주요 인공지능 모델들은 아프리카 언어 데이터셋에서 현저히 낮은 정확도를 보이며, 이는 언어별 모델 최적화가 아직 부족하다는 점을 방증한다.
AI 학습 데이터의 극심한 언어 편중
인공지능 모델은 상위 10개 언어가 지배하는 데이터셋으로 훈련되며, 수천 개의 저자원 언어는 웹 데이터의 0.1폭 미만을 차지한다. 영어, 러시아어, 독일어, 중국어, 프랑스어 등이 주요 학습 데이터를 구성한다. 아프리카와 동남아시아, 원주민 공동체의 수천 개 언어는 웹 데이터에서 소외되어 있다. 2천만 명이 쓰는 루간다어 같은 언어도 인터넷에서 작성된 예시를 찾기 어렵기 때문에 인공지능이 학습하기가 매우 까다롭다.

긴 맥락 처리 능력과 언어별 격차
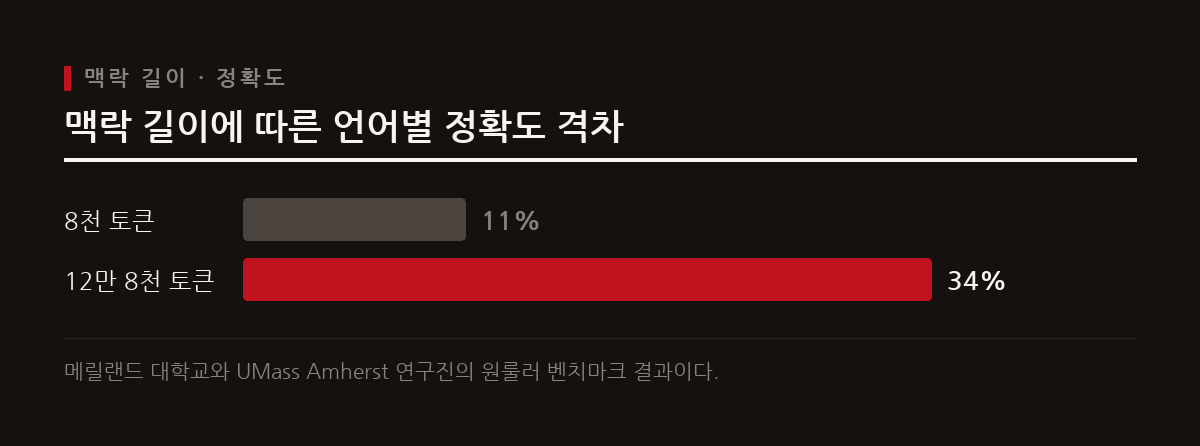
원룰러 벤치마크 평가에서 맥락 길이가 늘어날수록 상위 언어와 하위 언어 간의 정확도 격차가 크게 확대되는 것으로 나타났다. 한국어는 26개 언어 중 22위를 기록했으며 스와힐리어 등도 하위권에 속했다. 맥락 길이가 8천 토큰일 때 상하위 언어 간 정확도 차이는 11폭이었다. 맥락 길이가 12만 8천 토큰으로 늘어나자 격차는 34폭으로 3배 이상 확대되었다.
개발자가 직면한 AI 디바이드 시사점
인공지능 모델의 언어 불균형과 데이터 부족 문제는 전 세계 사용자에게 공정한 서비스를 제공하려는 개발자들에게 중요한 기술적 과제다. 저자원 언어 환경에서는 토큰 증가당 정확도 감소 문제가 심각하게 발생한다. 다국어 인공지능 서비스를 구축할 때는 언어별 학습 데이터의 품질을 면밀히 검토해야 한다. 문화적 조정과 새로운 벤치마크 도입을 통한 성능 보완 노력이 요구된다.
참고
- What Bill Gates Told Me About AI's Turning Point
- [2412.12417] Bridging the Gap: Enhancing LLM Performance for Low-Resource African Languages with New Benchmarks, Fine-Tuning, and Cultural Adjustments
- [논문리뷰] GPT-4o도 아프리카 언어 앞에서는 반토막 점수를 받는다 — IrokoBench: A New Benchmark for African Languages in the Age of Large Language Models
- AI 언어 이해력, 1위는 폴란드어…한국어 22위, 왜? - ZDNet korea
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.