AI 에이전트 개발이 고도화됨에 따라 컨텍스트 조각화와 토큰 폭발 문제는 시스템의 효율성을 저해하는 주요 원인으로 떠올랐다. 단순한 RAG 방식이나 단일 메모리 구조는 장기 대화에서 심각한 비효율을 초래한다. 이러한 한계를 극복하기 위해 등장한 OpenViking은 에이전트의 기억, 지식, 기술을 가상 파일 시스템 패러다임으로 통합 관리하는 오픈소스 컨텍스트 데이터베이스다. 개발자는 파일 시스템 명령어를 통해 에이전트의 컨텍스트를 직관적으로 다룰 수 있다.
AI 에이전트의 컨텍스트 문제를 해결하다
기존 AI 에이전트 개발 과정에서는 대화 기록과 외부 지식이 파편화되어 컨텍스트 조각화와 토큰 폭발 문제가 꾸준히 지적되었다. OpenViking은 에이전트의 기억, 지식, 기술을 하나의 가상 파일 시스템으로 통합 관리하여 이러한 한계를 정면으로 해결한다. 정보가 일관된 구조로 저장되기 때문에 탐색 과정에서 발생하는 불필요한 연산 손실을 대폭 줄일 수 있다.
이 데이터베이스는 viking:// 프로토콜을 통해 모든 데이터를 디렉토리 체계로 저장한다. 예를 들어 지식 자원은 viking://resources/ 경로에, 사용자 메모리는 viking://user/memories/ 경로에 배치된다. 에이전트는 ls, tree, read, write와 같은 익숙한 파일 시스템 명령어를 직접 실행하여 컨텍스트를 순회하거나 수정한다. 결과적으로 복잡한 벡터 검색 알고리즘을 매번 고안하지 않고도 기억을 유연하게 다룰 수 있게 된다.
계층적 컨텍스트 로딩 구조
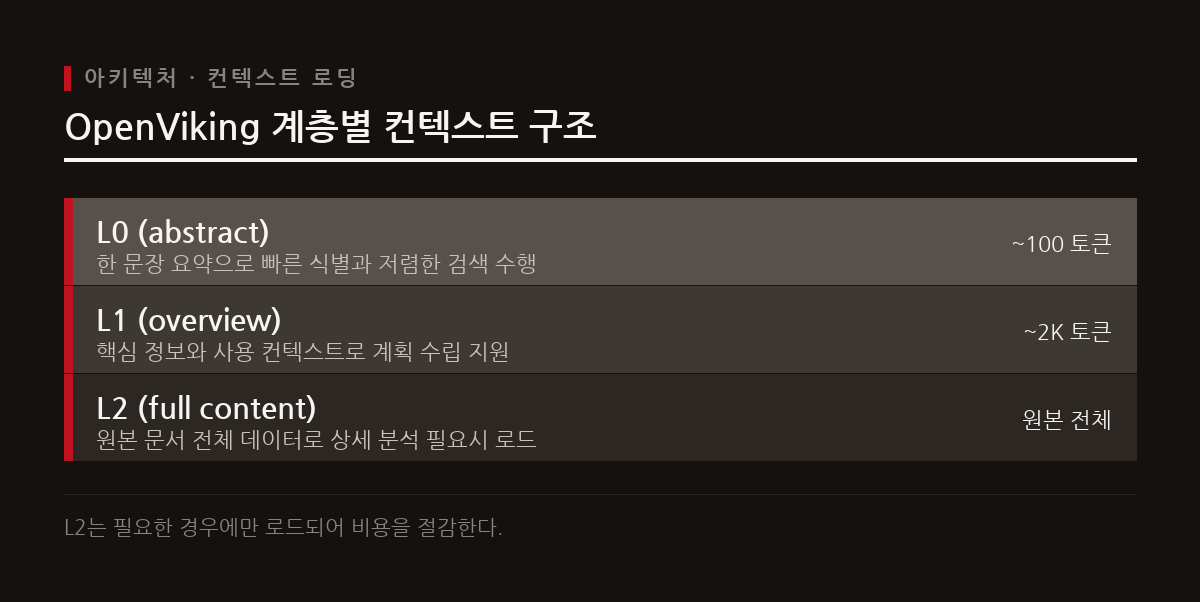
OpenViking은 정보를 효율적으로 다루기 위해 L0, L1, L2로 구성된 계층적 컨텍스트 로딩 방식을 채택했다. L0 단계는 약 100 토큰 분량의 한 문장 요약본으로, 빠른 정보 식별과 저렴한 탐색에 활용된다. L1 단계는 약 2K 토큰 규모의 개요로 계획 수립과 의사결정에 필요한 핵심 사용 맥락을 제공한다.
가장 상세한 원본 데이터인 L2 단계는 에이전트가 극도로 세부적인 정보가 필요하다고 판단할 때만 선택적으로 로드된다. 이러한 계층 구조를 통해 전체 문서를 매번 불러오는 비효율성을 없앴으며, 실제 생산 환경에서는 토큰 비용을 최대 96퍼센트까지 줄이는 성과를 거두었다.
실제 평가에서 증명된 성능 향상
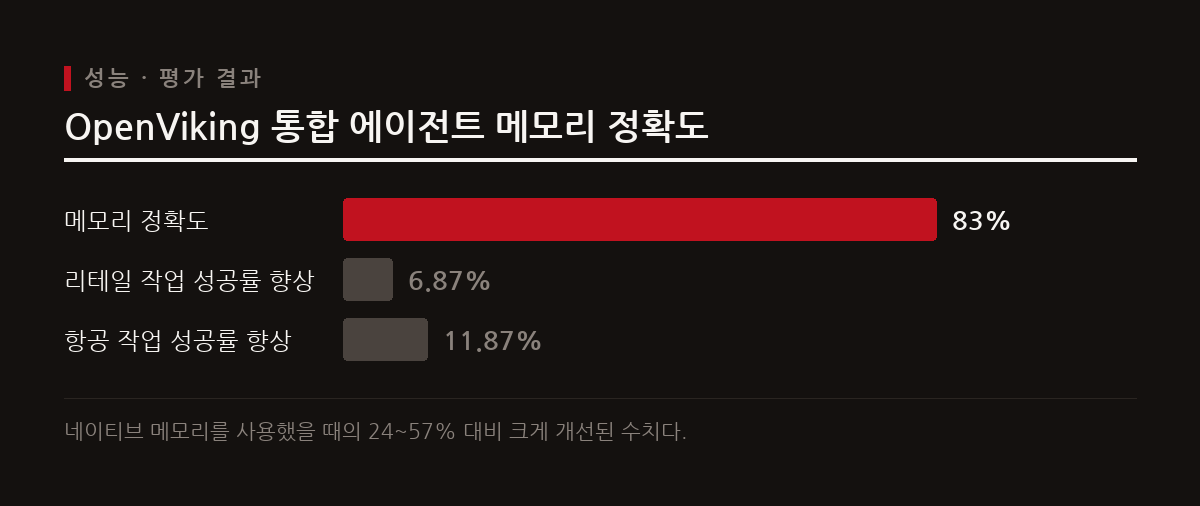
실제 성능 평가에서도 OpenViking을 적용한 에이전트 시스템은 비약적인 개선 효과를 입증했다. 장기 대화 메모리 성능을 측정하는 LoCoMo 평가 결과, 대화 메모리 정확도가 80퍼센트에서 83퍼센트 수준으로 대폭 향상되었다.
또한 통합 과정에서 입력 토큰 발생량은 최소 34.3퍼센트에서 최대 91.0퍼센트까지 감소했으며, 쿼리 지연 시간 역시 58.45퍼센트에서 66.10퍼센트가량 줄어들었다. 실제 에이전트 상호작용을 측정하는 tau2-bench 평가에서도 동일한 대형 언어 모델 대비 리테일 분야 작업 성공률이 6.87퍼센트포인트 상승했고, 항공 분야에서는 11.87퍼센트포인트 증가하여 실무 적용 가치를 나타냈다.
파일 시스템 기반 에이전트 개발의 미래
OpenViking은 오픈소스 생태계에서 빠르게 입지를 넓히고 있으며, 최신 v0.4.21 버전 기준으로 약 38.4K의 GitHub 스타 수를 기록했다. 주요 프로젝트 영역에 AGPL-3.0 라이선스를 적용하여 투명하고 지속 가능한 개발 환경을 보장한다. 개발자는 고도의 벡터 검색 인프라를 매번 새로 구축할 필요 없이 파일 시스템 인터페이스만으로 고성능 에이전트 기억 장치를 구현할 수 있다.
시간이 지남에 따라 에이전트가 새로운 사용자 대화와 작업 경험을 파일 형태로 누적하고 개편하는 자기 진화 구조를 지원한다. 이러한 표준화된 접근 방식은 단순 대화형 서비스에 머물지 않고 복잡한 업무를 자동 수행하는 차세대 AI 에이전트 아키텍처의 강력한 기틀을 제공한다.
참고
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.