AI를 활용한 딥리서치 도구들이 늘어나고 있지만, 조사가 끝나면 수집한 출처를 버리거나 비판 단계에서 보고서 전체를 다시 작성하며 새로운 환각을 유발하는 구조적 결함이 꾸준히 지적되어 왔다. 이러한 한계를 극복하기 위해 개발자 조던 깁스(Jordan Gibbs)가 공개한 hyperresearch는 앤트로픽의 Claude Code CLI 도구와 연동되는 오픈소스 심층 조사 하네스다. 영구 보관소 기반 연구용 기억 시스템과 16단계 다단계 파이프라인을 갖춘 hyperresearch의 주요 구조와 구동 원리를 자세히 정리한다.
hyperresearch, 기존 AI 조사의 한계를 넘다
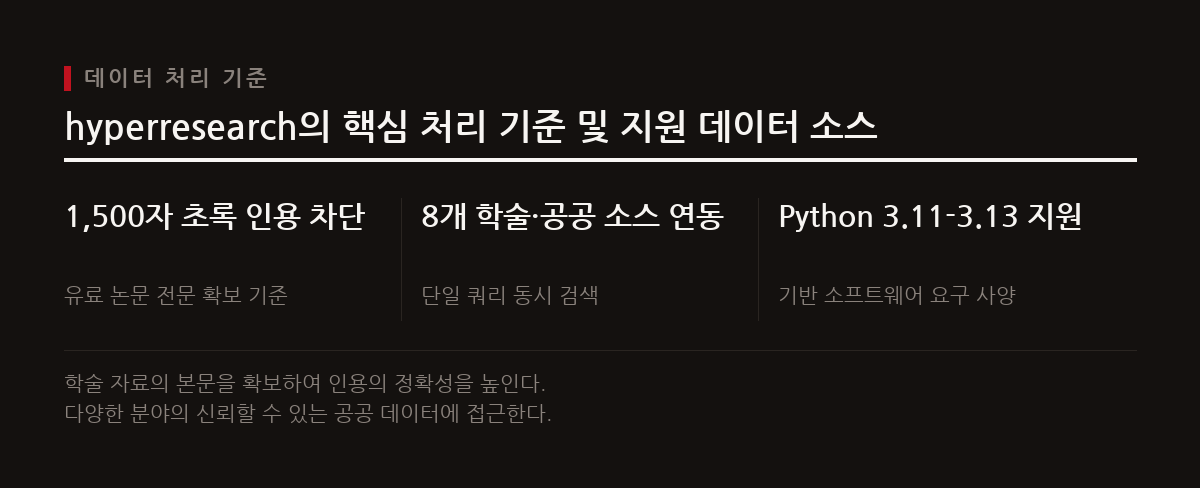
hyperresearch는 개발자 조던 깁스가 공개한 MIT 라이선스 기반의 오픈소스 Python 패키지다. 이 도구는 앤트로픽의 에이전트 CLI 도구인 Claude Code에 연동되어 심층 조사를 수행하는 스킬 하네스로 작동한다. 실행 시 Python 3.11에서 3.13 환경을 요구하며 현재 Python 3.14 버전은 지원하지 않는다.
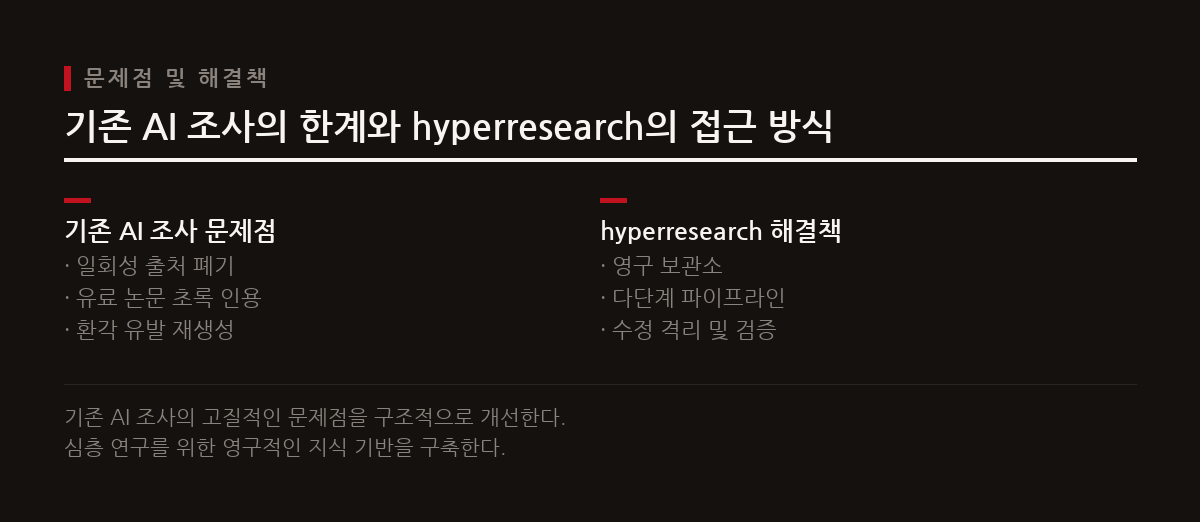
기존의 일회성 AI 딥리서치 도구들은 조사가 완료된 후 수집한 출처 데이터를 폐기하기 때문에 다음 조사 시 동일한 검색 과정을 반복해야 하는 비효율성이 존재했다. 또한 유료 논문의 일부 요약문이나 1,500자 안팎의 초록만 읽고 본문을 전부 파악한 것처럼 인용하거나, 작성된 보고서를 수정할 때 모델이 전체 문장을 새로 쓰면서 새로운 환각을 만들어내는 문제가 지속적으로 발생했다. hyperresearch는 이러한 구조적 한계를 해결하기 위해 설계되었다.
영구 보관소 기반 연구용 기억 시스템 구축
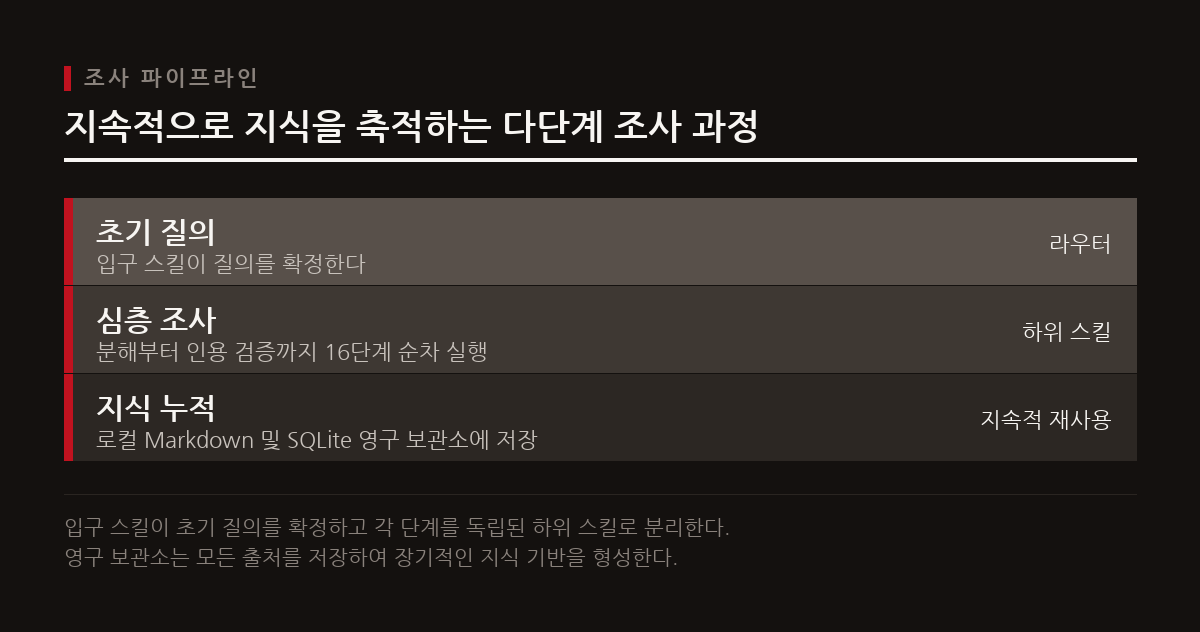
hyperresearch는 수집된 모든 출처 자료를 로컬 환경의 Markdown 파일과 SQLite 색인 기반 영구 보관소(Vault)에 저장한다. 이후 새로운 조사를 수행할 때 외부 웹에서 신규 문서를 가져오기 전에 보관소 내부 데이터를 먼저 검색하고 재사용한다. 이를 통해 조사가 거듭될수록 연구 지식이 지속적으로 누적되는 구조를 갖춘다.
단일 프롬프트에 모든 지시를 넣었을 때 발생하는 컨텍스트 훼손(Context Rot) 현상을 막기 위해 hyperresearch는 파이프라인을 철저히 분리한다. 입구 스킬이 사용자의 질의를 확정한 뒤, 각 단계를 독립된 하위 스킬로 나누어 최대 16단계에 이르는 파이프라인을 순차적으로 실행한다.
보고서 품질을 높이는 적대적 검증 및 수정 격리
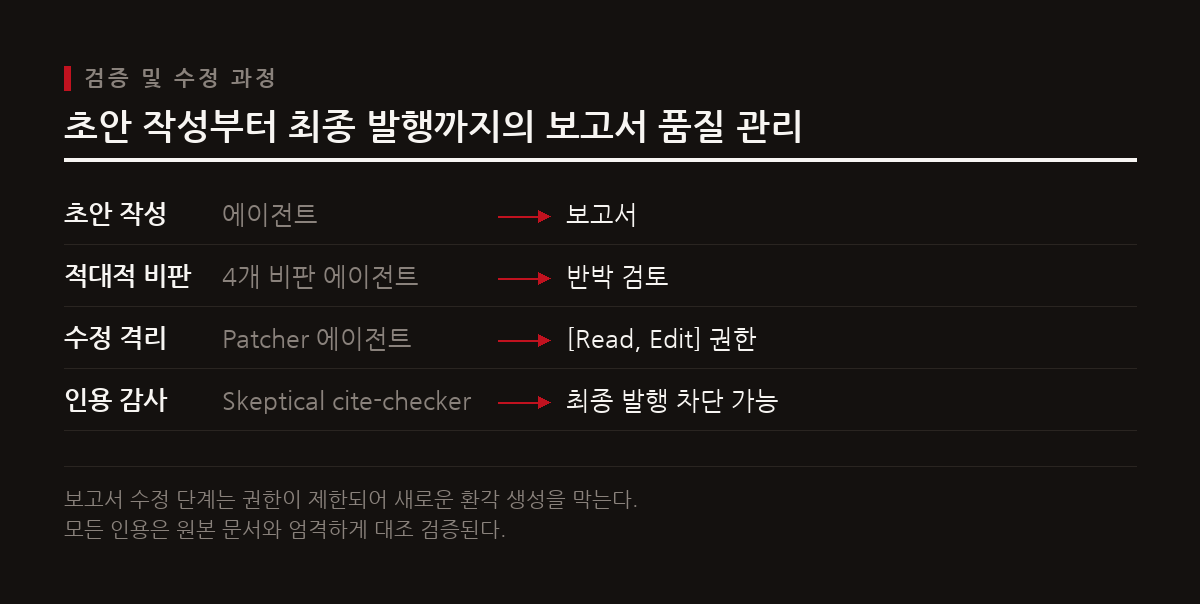
초안 보고서가 완성되면 4개의 독립된 비판 에이전트가 병렬로 가동되어 작성된 주장에 대한 반박과 허점을 검토한다. 이 과정에서 발생할 수 있는 환각을 막기 위해 보고서를 수정하는 단계(Patcher 등)는 Claude Code 허용목록 수준에서 [Read, Edit] 권한으로 도구 사용이 제약된다. 전체 문장을 새로 출력하는 재생성 권한이 물리적으로 차단되어 오직 지정된 위치만 수정할 수 있다.
수정이 완료된 이후에는 회의적 인용 감사(Skeptical cite-checker) 에이전트가 가동된다. 인용문이 영구 보관소에 저장된 원본 문서와 토큰 단위로 정확히 일치하는지 엄밀하게 검사하며, 이 검증을 통과하지 못하면 보고서의 최종 발행이 차단된다.
조사 깊이에 따른 실행 단계와 출처 처리 규모
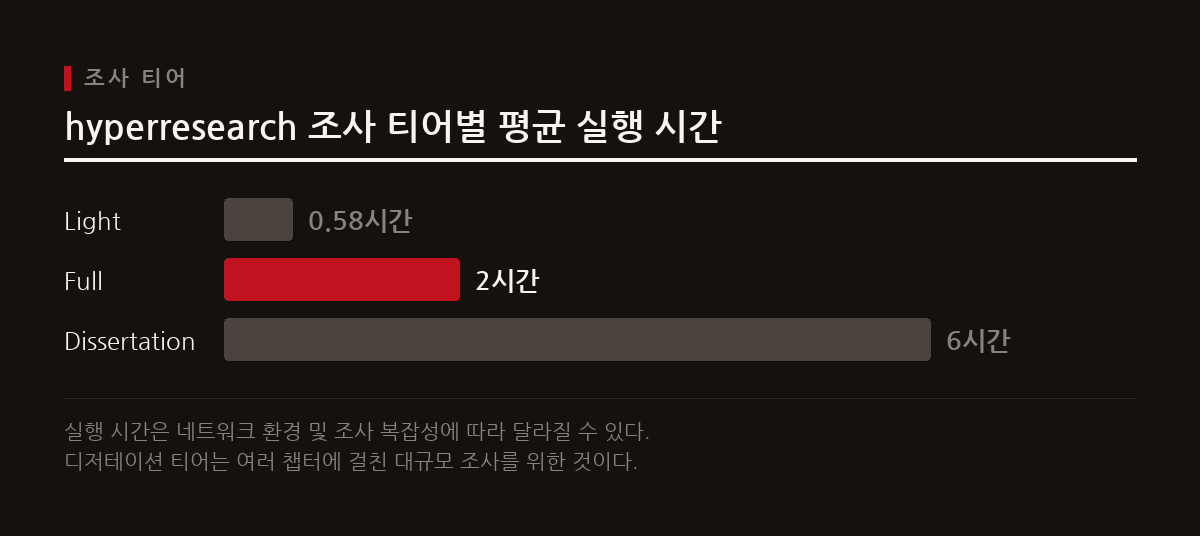
hyperresearch는 연구의 범위와 목적에 맞춰 선택할 수 있는 3가지 실행 티어를 제공한다. 간단한 사실 확인을 위한 Light 티어는 5단계 파이프라인으로 구성되며 약 30분에서 40분이 소요된다. 기본 설정이자 깊이 있는 심층 분석을 수행하는 Full 티어는 16단계 파이프라인과 인용 감사를 모두 거치며 약 1.5시간에서 2.5시간 동안 구동된다. 방대한 범위를 다루는 Dissertation 티어는 4개에서 10개의 챕터로 나뉘어 약 4시간에서 8시간 동안 실행된다.
수행 규모 측면에서도 차별화된 성능을 보인다. 1회 실행당 최소 250개 이상의 출처(250+ sources)를 수집 및 분석할 수 있으며, Dissertation 티어 기준으로는 300개에서 450개에 달하는 출처를 처리하여 종합적인 보고서를 작성한다.
출처 무결성 확보 및 광범위한 데이터 연동
학술 논문 인용의 신뢰성을 높이기 위해 hyperresearch는 1,500자 분량의 초록(Abstract)만으로 문장을 구성하는 스키밍 인용을 엄격히 차단한다. 유료 논문이라도 Unpaywall, Europe PMC, CORE 등 오픈 액세스 엔진을 활용해 정법으로 전문(Full text)을 확보하여 보관소에 저장한다.
또한 단일 클라이언트 계층에서 OpenAlex, Crossref, CORE, DOAB, ClinicalTrials.gov, SEC EDGAR, FRED 등 8개 학술 및 공공 데이터 소스를 한 번의 쿼리로 동시에 검색한다. 가져온 데이터는 DOI 및 제목을 기준하여 자동으로 중복이 제거된 목록으로 정돈된다.
AI 딥리서치의 새로운 표준, hyperresearch
hyperresearch는 지속 가능한 영구 보관소, 컨텍스트 분리 기반의 다단계 파이프라인, 수정 격리 및 회의적 인용 감사 메커니즘을 결합하여 기존 AI 딥리서치의 환각과 정확성 문제를 효과적으로 통제한다. 내부 평가 벤치마크인 DeepResearch-Bench RACE에서 58.3 / 100 점을 기록하며 우수한 성능을 입증하기도 했다. 다만 제3자 기관에 의한 공인 벤치마크 검증은 현재 대기 중인 상태로 확인된다.
현업 개발자라면 Claude Code 환경에서 hyperresearch를 적용해 단순 질의응답을 넘어 지속적으로 지식이 누적되는 자체 연구 기억 시스템을 구축해볼 수 있다.
참고
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.