 유명한형제들
AI 딥리서치 도구는 늘고 있지만, 조사가 끝나면 모은 출처를 버리거나 비판 단계에서 보고서 전체를 다시 쓰다가 새 환각을 만든다는 구조적 결함이 계속 지적돼 왔다. 개발자 조던 깁스(Jordan Gibbs)가 공개한 hyperresearch는 이 한계를 풀려고 만든 오픈소스 심층 조사 하네스로, 앤트로픽의 Claude Code CLI 도구와 연동된다. 영구 보관소 기반 연구용 기억 시스템과 16단계 파이프라인을 갖춘 hyperresearch의 구조와 작동 방식을 정리한다.
hyperresearch, 기존 AI 조사의 한계를 넘다
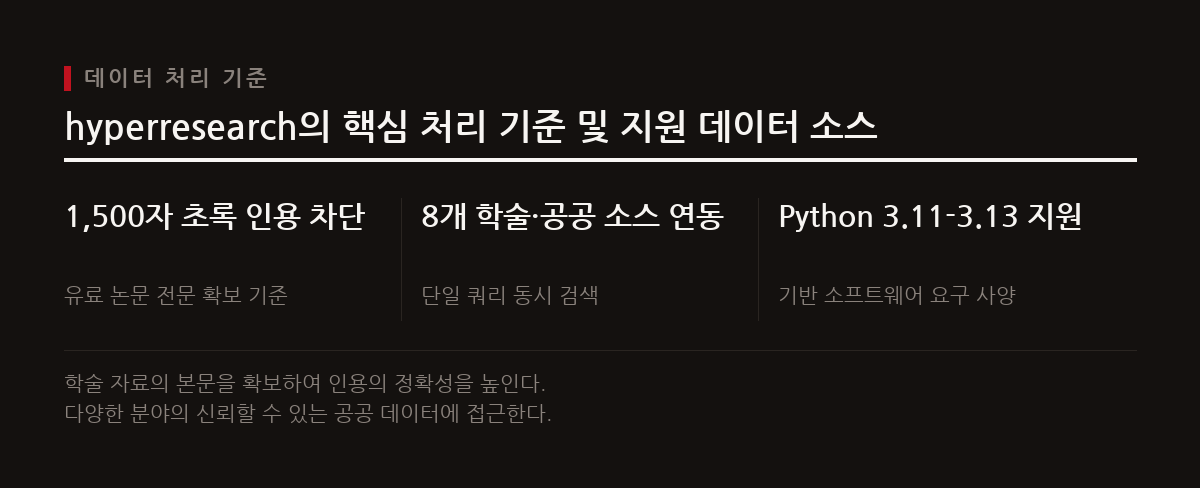
hyperresearch는 개발자 조던 깁스가 공개한 MIT 라이선스 오픈소스 Python 패키지다. 앤트로픽의 에이전트 CLI 도구 Claude Code에 붙어 심층 조사를 하는 스킬 하네스로 작동한다. Python 3.11에서 3.13 환경이 필요하고, Python 3.14는 아직 지원하지 않는다.
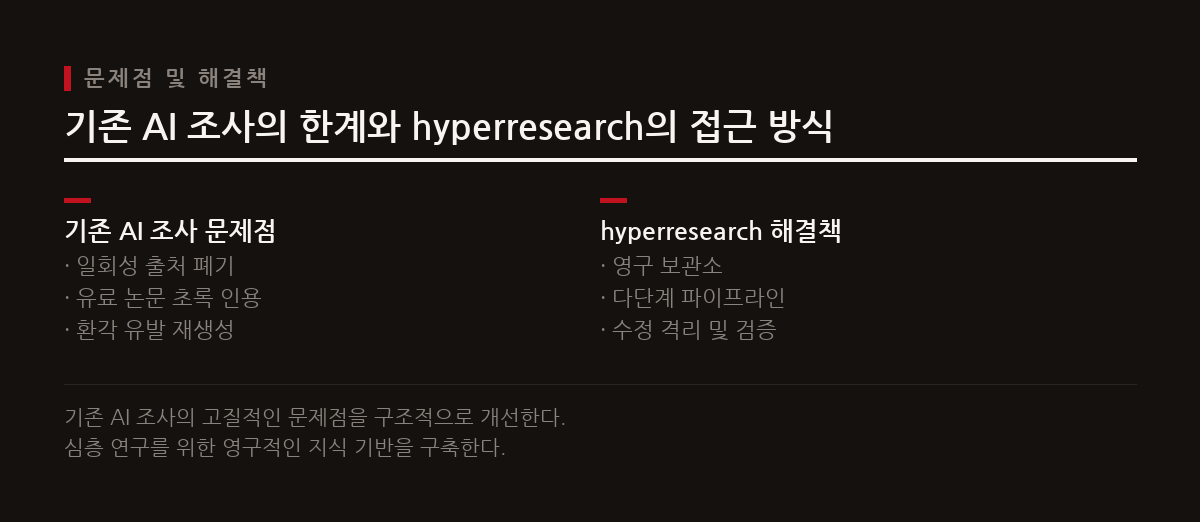
기존의 일회성 AI 딥리서치 도구는 조사가 끝나면 모은 출처 데이터를 버리기 때문에 다음 조사 때 같은 검색을 되풀이해야 했다. 유료 논문의 일부 요약이나 1,500자 안팎의 초록만 읽고 본문을 다 본 것처럼 인용하는 일, 보고서를 고칠 때 모델이 문장 전체를 새로 쓰면서 새 환각을 만드는 일도 계속됐다. hyperresearch는 이런 구조적 한계를 풀려고 설계됐다.
영구 보관소 기반 연구용 기억 시스템 구축
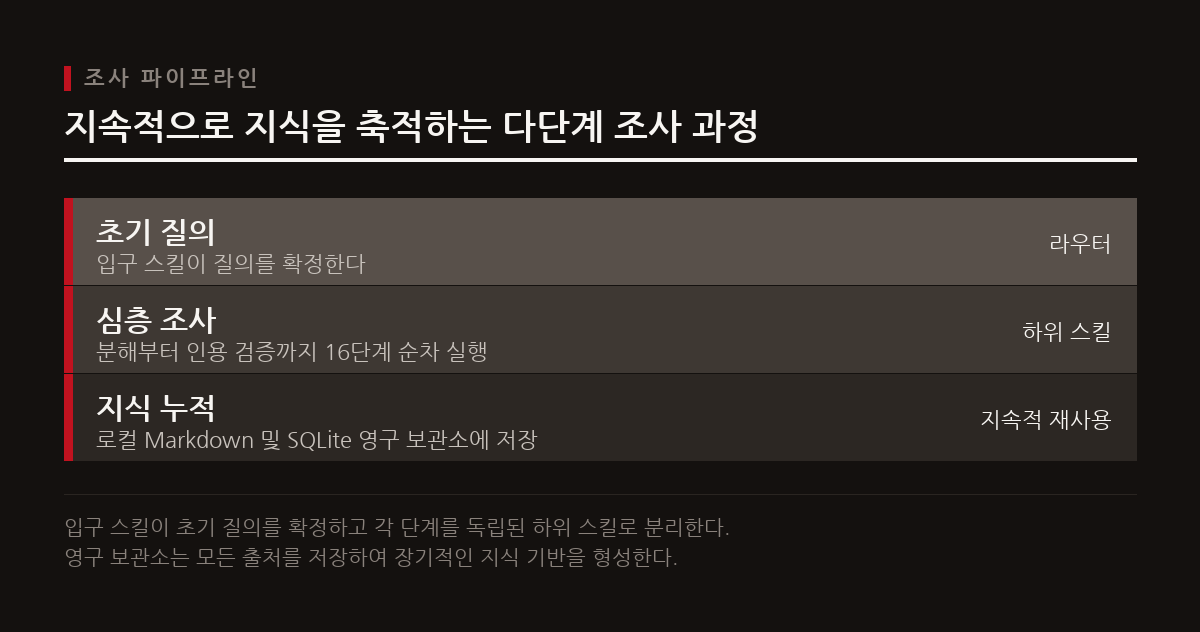
hyperresearch는 모은 출처 자료를 전부 로컬의 Markdown 파일과 SQLite 색인 기반 영구 보관소(Vault)에 저장한다. 새 조사를 할 때는 외부 웹에서 문서를 가져오기 전에 보관소부터 검색해 재사용한다. 조사를 거듭할수록 연구 지식이 쌓이는 구조다.
프롬프트 하나에 모든 지시를 몰아넣으면 생기는 컨텍스트 훼손(Context Rot)을 막으려고, hyperresearch는 파이프라인을 철저히 나눈다. 입구 스킬이 사용자의 질의를 확정하면, 각 단계를 독립된 하위 스킬로 나눠 최대 16단계 파이프라인을 차례로 실행한다.
보고서 품질을 높이는 적대적 검증 및 수정 격리
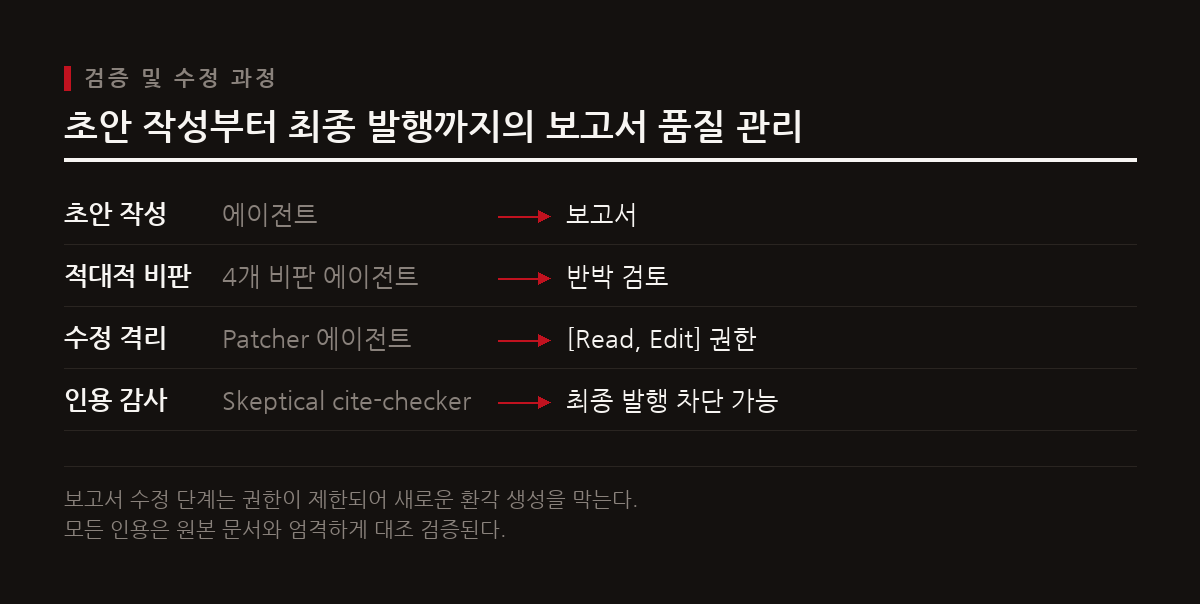
초안 보고서가 나오면 독립된 비판 에이전트 4개가 병렬로 돌아가며 주장의 반박거리와 허점을 찾는다. 이때 환각이 끼어들지 않도록, 보고서를 고치는 단계(Patcher 등)는 Claude Code 허용목록에서 [Read, Edit] 권한으로만 도구를 쓸 수 있다. 문장 전체를 새로 출력하는 재생성 권한이 아예 막혀 있어 지정된 위치만 고칠 수 있다.
수정이 끝나면 회의적 인용 감사(Skeptical cite-checker) 에이전트가 돌아간다. 인용문이 보관소의 원본 문서와 토큰 단위로 정확히 일치하는지 검사하고, 통과하지 못하면 보고서는 최종 발행되지 않는다.
조사 깊이에 따른 실행 단계와 출처 처리 규모
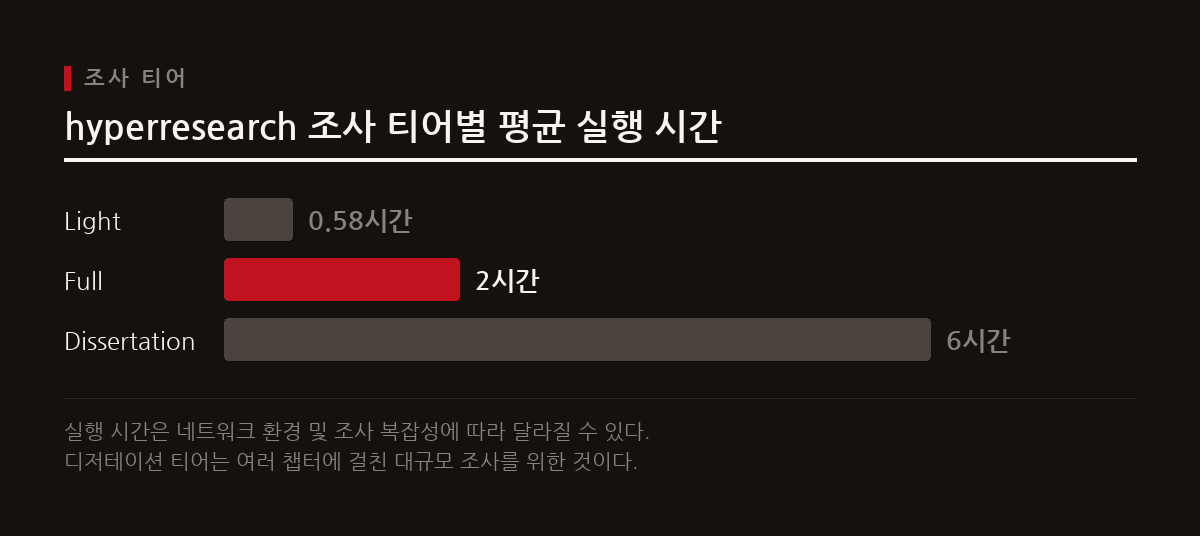
hyperresearch에는 조사 범위와 목적에 따라 고르는 실행 티어가 3가지 있다. 간단한 사실 확인용 Light 티어는 5단계 파이프라인으로 약 30분에서 40분 걸린다. 기본값인 Full 티어는 16단계 파이프라인과 인용 감사를 모두 거치며 약 1.5시간에서 2.5시간 돌아간다. 범위가 넓은 Dissertation 티어는 4개에서 10개 챕터로 나뉘어 약 4시간에서 8시간 실행된다.
처리하는 출처도 많다. 한 번 실행할 때 최소 250개 이상의 출처(250+ sources)를 모아 분석하고, Dissertation 티어에서는 300개에서 450개 출처를 처리해 보고서를 만든다.
출처 무결성 확보 및 광범위한 데이터 연동
학술 논문 인용을 믿을 수 있게 하려고, hyperresearch는 1,500자 분량의 초록(Abstract)만 보고 문장을 쓰는 스키밍 인용을 막는다. 유료 논문이라도 Unpaywall, Europe PMC, CORE 같은 오픈 액세스 엔진으로 합법적으로 전문(Full text)을 구해 보관소에 저장한다.
클라이언트 계층 하나에서 OpenAlex, Crossref, CORE, DOAB, ClinicalTrials.gov, SEC EDGAR, FRED 등 학술·공공 데이터 소스 8개를 쿼리 한 번으로 함께 검색한다. 가져온 데이터는 DOI와 제목을 기준으로 중복을 자동으로 걸러 목록으로 정리한다.
AI 딥리서치의 새로운 표준, hyperresearch
hyperresearch는 영구 보관소, 컨텍스트를 나눈 다단계 파이프라인, 수정 격리, 회의적 인용 감사를 묶어 기존 AI 딥리서치의 환각과 정확성 문제를 잡는다. 내부 평가 벤치마크 DeepResearch-Bench RACE에서는 58.3 / 100 점을 기록했다. 다만 제3자 기관의 공인 벤치마크 검증은 아직 대기 중이다.
Claude Code를 쓰는 개발자라면 hyperresearch를 붙여, 질의응답에 그치지 않고 지식이 계속 쌓이는 자체 연구 기억 시스템을 만들어 볼 수 있다.
참고
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.