 유명한형제들
대형 모델의 연산 요구량이 커지면서 개인 개발자 환경에서도 거대 모델을 돌리기 위한 경량화 기술이 중요해졌다. 최신 최적화 아키텍처가 서로 맞물리면서 하드웨어 제약을 넘을 길도 생겼다. 이제 개발자들은 비싼 클라우드에 기대지 않고도 로컬 환경에서 지연 시간을 조절하며 인공지능 에이전트를 통합하고 실험할 수 있는 기술적 바탕을 갖추게 됐다.
320B 대형 모델 GLM-5.3-Flash의 로컬 추론
GLM-5.3-Flash는 추론, 코딩, 에이전트 작업을 지원하는 멀티모달 MoE 모델이다. 하이브리드 희소 및 선형 어텐션 아키텍처를 넣어 최대 1M 토큰의 긴 컨텍스트를 안정적으로 지원한다.
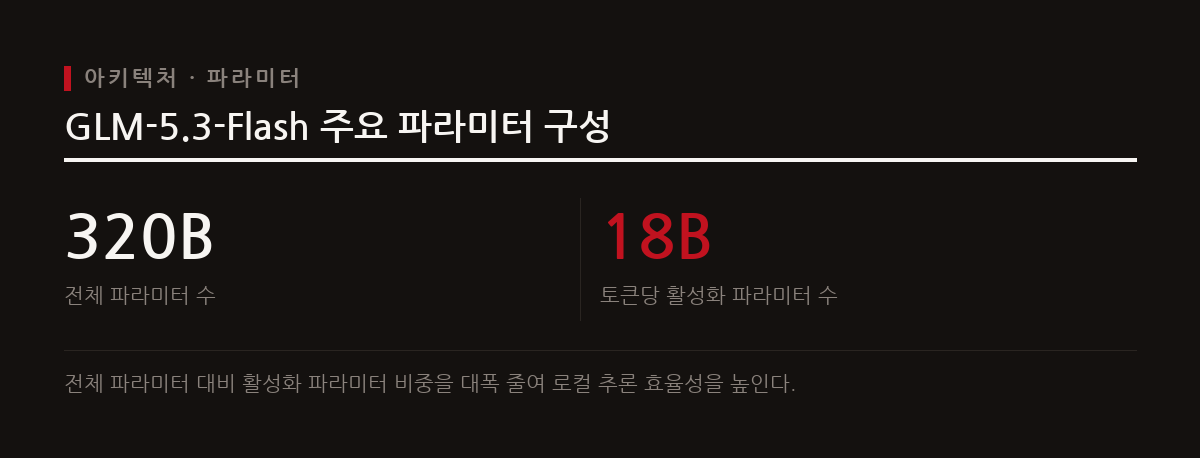
전체 파라미터는 320B에 이르는 거대 규모지만, 실제 추론 때는 토큰당 18B의 활성 파라미터만 돌려서 연산 비용을 크게 낮춘다는 점이 이 모델의 기술적 차별점이다.
MoE 아키텍처의 게이팅 및 자원 효율화
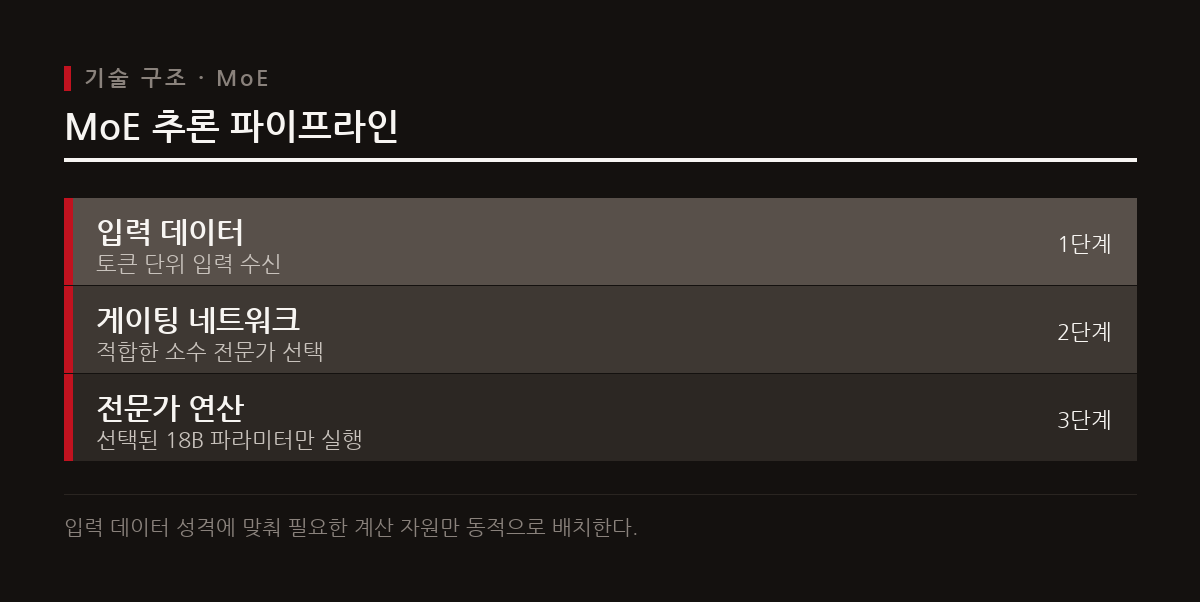
MoE 아키텍처는 모델 전체에 들어 있는 전문가 네트워크 가운데 가장 알맞은 일부만 골라 돌린다. 게이팅 네트워크가 입력 토큰마다 맞는 전문가 몇 개를 실시간으로 골라 연산을 보내기 때문이다.
그래서 전체 모델이 아무리 커도 실제 추론에는 최소한의 파라미터만 활성화된다. 비싼 장비 없이도 GPU 메모리와 연산 자원 소모를 크게 아끼면서 높은 효율을 낼 수 있다.
GGUF 포맷을 통한 로컬 양자화 추론
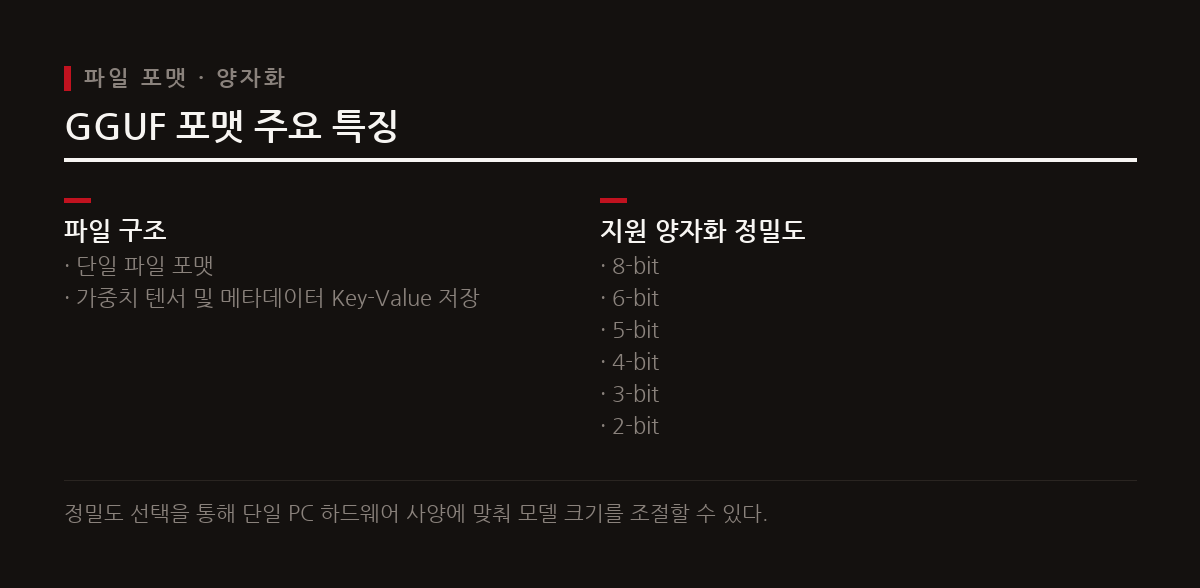
GGUF는 거대 모델을 개인 컴퓨터 환경에서 불러와 실행하려고 만든 단일 파일 형식이다. Georgi Gerganov가 GGML 라이브러리를 바탕으로 개발한 이 포맷은 가중치 텐서와 메타데이터를 Key-Value 구조로 묶어 처리 효율을 높인다.
여러 정밀도의 양자화를 폭넓게 지원하기 때문에 모델 크기와 필요한 VRAM 용량을 크게 줄이고, 로컬에서 실행하는 문턱도 많이 낮춘다.
Unsloth 프레임워크의 파인튜닝 및 추론 가속
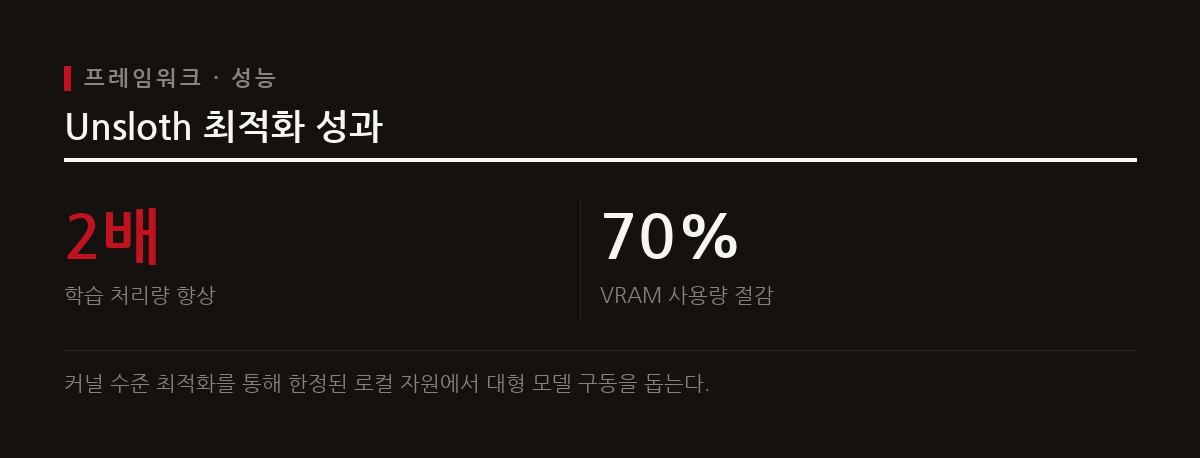
Unsloth는 로컬 파인튜닝과 추론 가속을 지원하는 오픈소스 도구다. 자체 Triton 커널을 바탕으로 모델 정확도 손실 없이 VRAM 사용량을 70% 줄이고 학습 처리량을 2배로 높인다.
또 Unsloth Studio는 훈련 오케스트레이션과 로컬 추론 서버 환경을 한 플랫폼에 묶어 개발자가 파이프라인을 더 빨리 관리하도록 돕는다. 한편 Unsloth로 가속하면 GLM-5.3-Flash 성능이 몇 배 오른다는 견해도 있지만, 구체적인 수치를 담은 벤치마크나 기술 보고서는 공식 확인되지 않았다.
MTP와 추측성 디코딩을 통한 토큰 생성 가속
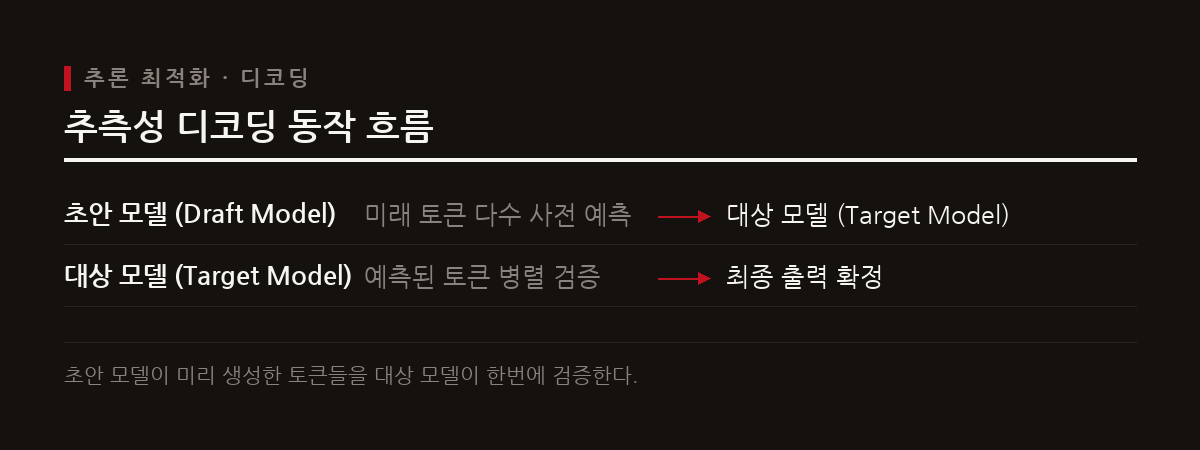
추측성 디코딩과 MTP 기법은 토큰 생성 과정을 앞당기는 기술이다. 추측성 디코딩은 빠른 초안 모델이 여러 토큰을 먼저 예측하고 원본 모델이 이를 병렬로 검증하는 방식으로, 순차 생성에서 생기는 지연 시간을 크게 줄인다.
여기에 미래 토큰 여러 개를 한 번에 동시에 예측하게 하는 MTP 방식을 더하면 추론 속도와 처리량을 최대로 끌어올리고 클라우드 운영 비용 부담도 크게 줄일 수 있다.
로컬 고성능 AI 개발 환경 구축의 미래
MoE, GGUF, Unsloth, MTP를 함께 쓰면 개인 PC 환경에서도 320B급 대형 모델을 충분히 다룰 수 있다. 하드웨어 제약을 넘기 위한 경량화와 추론 최적화 노하우는 이제 AI 개발자에게 없어서는 안 될 필수 도구로 자리 잡았다.
개발자는 비싼 클라우드 비용을 줄이고, 데이터 유출 걱정이 없는 로컬 시스템에서 자기만의 고성능 모델을 안전하고 빠르게 파인튜닝해 운용할 수 있다.
참고
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.