 유명한형제들
프론티어 AI 모델의 성능이 올라가면서 여러 모델을 조합해 쓰는 멀티 에이전트 환경에 관심이 커지고 있다. GPT-6 Astra와 Claude Fable 5.1 같은 고성능 프론티어 모델을 나란히 배치하는 시도가 이어지는 한편, 운영 비용을 줄이려고 Google의 Gemma 4 26B 같은 오픈소스 로컬 모델을 다중 GPU에서 병렬 서빙하는 연구도 활발하다. 이 글에서는 두 흐름의 기술 동향과 로컬 추론 성능을 끌어올리는 실무 방법을 살펴본다.
프론티어 AI 에이전트의 병렬 활용 동향
GPT-6 Astra와 Claude Fable 5.1을 병렬로 배치해 에이전트를 만드는 테스트가 계속되고 있다. 실제 업무와 에이전트 빌딩 협업에서 두 모델이 서로의 빈 곳을 메우도록 쓰는 실증 작업이다. 100점 만점 종합 평가에서 GPT-6 Astra는 86점, Claude Fable 5.1은 84점으로 거의 비슷했다.
세부 영역을 보면 Fable 5.1은 코드 구조화와 기획에서 90점을 받아 78점인 Astra를 앞섰다. Astra는 자율 앱 개발 테스트를 약 32분 만에 끝내 약 44분이 걸린 Fable보다 빨랐고, 자가 수정 검증을 거친 기능 완성도에서도 87점으로 Fable의 85점보다 높았다. AI 탐지 도구 GPTZero로 검사하니 두 모델이 쓴 텍스트 모두 100% AI 작성으로 판정됐다.
일부 개인 연구 메모에 적힌 대규모 기사 데이터화 작업이나, 에이전트·메신저·위키를 묶은 종합 프로그램 개발 같은 성과는 공식 발표로 확인되지 않았다. 개발자는 확인되지 않은 비공식 사례와 실측 벤치마크를 철저히 구분해서 아키텍처를 설계해야 한다.
Gemma 4 26B 기반 로컬 추론 환경 구성
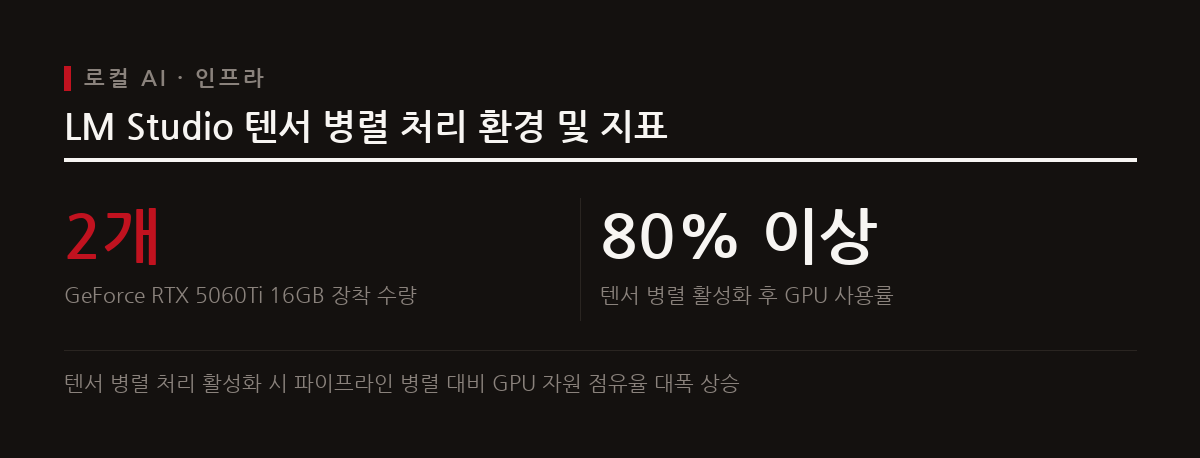
비싼 프론티어 API에만 기대지 않는 대안으로 Google Gemma 4 26B 로컬 모델을 쓰는 방법이 많이 공유되고 있다. 하드웨어를 효율적으로 쓰기 위해 같은 규격의 GeForce RTX 5060Ti 16GB 그래픽카드 2개를 단 다중 GPU 환경에서 로컬 추론을 검증한 사례가 있다.
기존 파이프라인 병렬 처리에서는 두 GPU의 사용률이 각각 40%대였다. LM Studio에서 텐서 병렬 처리를 켜자 두 그래픽카드 사용률이 모두 80%를 넘었다. 하드웨어는 그대로 두고 텐서 병렬 처리만 켜서 자원 효율을 크게 높일 수 있다는 것이 확인된 셈이다.
LM Studio에서 텐서 병렬 처리를 켠 이 환경 지표는 다중 GPU를 쓰려는 개발자에게 자원을 어떻게 나눌지 구체적인 기준이 된다. 로컬 환경의 자원 제약 안에서 성능을 최대한 뽑으려면 이런 병렬 구성 지표를 꾸준히 확인해야 한다.
로컬 모델 구조와 병렬 처리 방식 구분
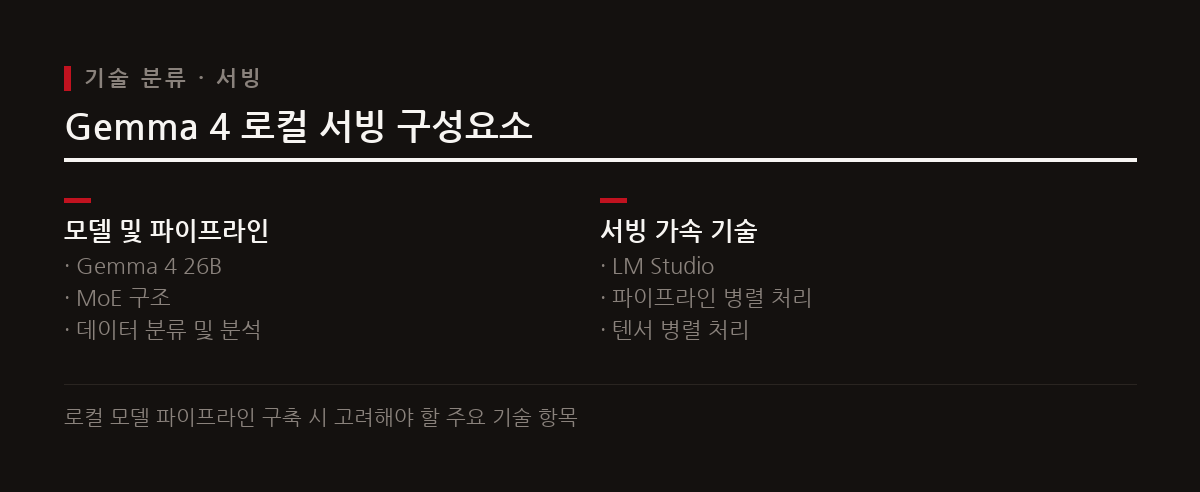
Gemma 4 26B는 혼합 전문가 구조의 대표적인 로컬 모델로, 대규모 데이터 분류와 분석 파이프라인에 잘 맞는다. 이 정도 규모의 모델을 로컬에서 효율적으로 돌리려면 다중 GPU를 다루는 병렬 처리 방식을 정확히 이해하고 구별해야 한다.
LM Studio에서 텐서 병렬 처리를 쓰면 연산 하나를 쪼개 여러 GPU가 동시에 계산한다. 레이어 단위로 작업을 나눠 차례로 처리하는 파이프라인 병렬 처리와는 자원을 쓰는 방식이 전혀 다르다. 파이프라인 방식은 단계마다 대기가 생기지만, 텐서 병렬 처리는 여러 GPU의 연산 유닛을 동시에 돌린다.
그러니 개발자는 서비스의 실제 처리 규모와 다중 GPU 환경의 메모리 대역폭을 보고 병렬 서빙 옵션을 골라야 한다. 병렬 옵션을 무조건 켜기보다 모델의 아키텍처 특성을 먼저 파악하고 매개변수를 배치하는 것이 순서다.
프론티어 API와 로컬 모델의 효율적 배분
결국 고성능 프론티어 에이전트와 로컬 Gemma 4 모델을 섞어 하이브리드 개발 워크플로를 만드는 것이 목표다. 고수준 추론, 기획, 복잡한 코드 작성 같은 상위 작업은 GPT-6 Astra나 Claude Fable 5.1에 맡기고, 정형화된 대량 데이터 분류나 반복 분석은 로컬 Gemma 4 26B에 넘기는 식으로 나누면 쓸모가 있다.
다만 텐서 병렬 처리로 GPU 사용률이 80%를 넘었다고 해서 실제 처리 속도가 그만큼 빨라지는지는 따로 따져 봐야 한다. 하드웨어 병목 구간과 전송 지연을 직접 측정해 봐야 실제 운영에서 낭비를 줄일 수 있다.
정치학 논문용 기사 65,000건 분석이나 특정 에이전트 종합 프로그램처럼 공개되지 않은 작업 메모 수준의 이야기는 공식 명세나 벤치마크와 엄격히 분리해서 평가해야 한다. 파이프라인 튜닝은 실측한 기술 지표를 근거로 해야 한다.
참고
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.