 유명한형제들
AI 기술이 발전하면서 금융과 주식 정보를 AI로 모으는 시대가 열렸지만, 기존 시스템은 요약 수준에 머문다. 퍼플렉시티가 공개한 오픈 벤치마크 WANDR은 AI 리서치 에이전트가 정보를 얼마나 넓게 모으고 증거를 얼마나 철저히 따지는지를 평가해, 자율형 분석 기술이 넘어야 할 다음 기준을 제시한다.
AI 리서치 에이전트의 새 기준, WANDR
기존 AI 성능 평가는 질의응답이나 문서 요약 수준에 머물러, 복잡한 시장 조사를 해내는 에이전트의 실력을 검증하기 어려웠다. WANDR은 증거에 기반한 대규모 지식 작업을 정확히 평가하려고 만든 도구다.
이 벤치마크는 조건에 맞는 대상을 널리 찾아내는 '광범위한' 검색과, 모은 정보가 타당한지 입증하는 '심층적인' 조사를 동시에 요구한다. 정보를 긁어모으는 데서 그치지 않고 실제 연구원처럼 일하는지를 본다.
꼬리를 무는 계층적 정보 탐색 능력 검증
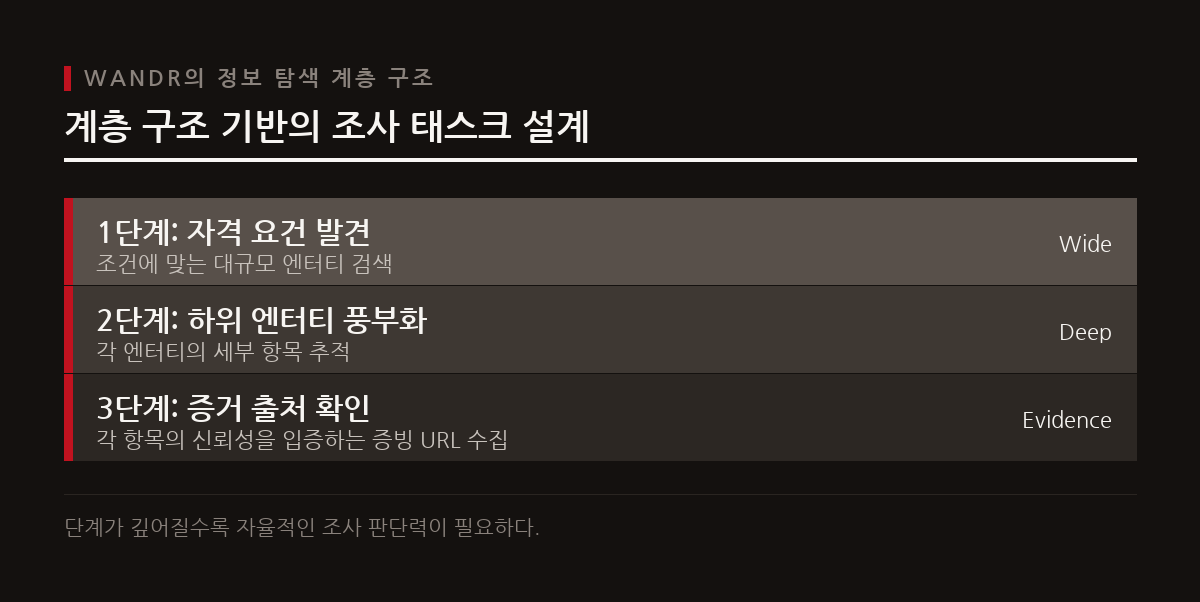
WANDR은 회사에서 직원으로, 다시 증빙 웹페이지로 꼬리를 물고 이어지는 다단계 계층 구조의 탐색 과제를 만들어 AI를 시험한다. 2026년 봄에 임원을 발표한 미국 기업 70곳과 관련 증빙 웹페이지를 합쳐 모두 140개의 기록을 모으는 과제가 대표적이다.
이런 계층 구조로 조사할 때 목표 수량이 늘고 계층이 깊어질수록, 최고 수준의 AI 시스템조차 정보 탐색 성공률이 크게 떨어지는 약점을 드러낸다.
진짜 증거인지 끝까지 추적하는 검증법
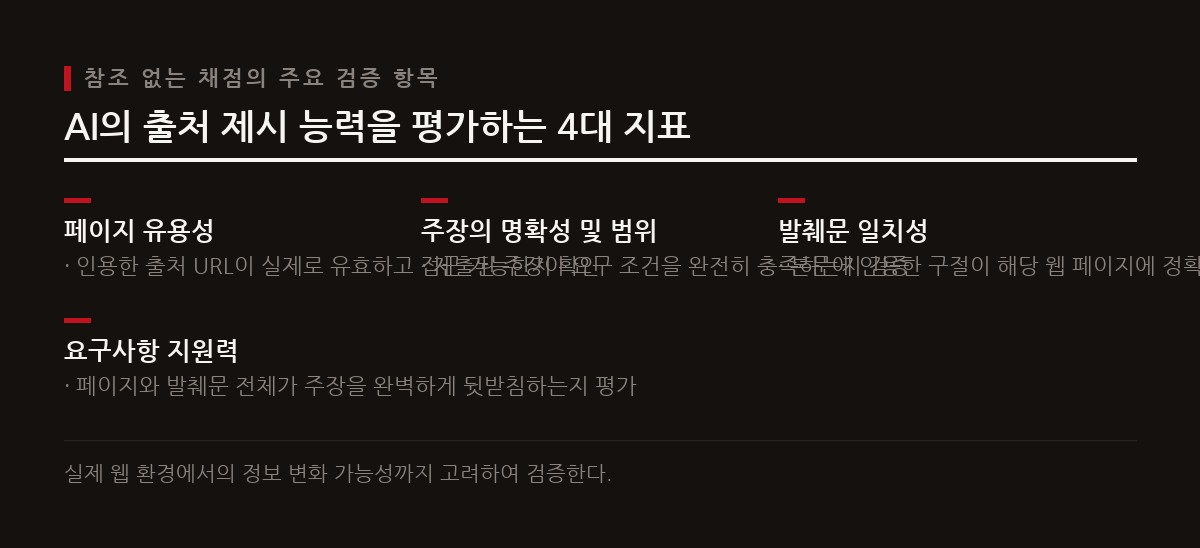
이 벤치마크는 정해진 모범 답안 대신, AI가 내놓은 출처가 믿을 만한지를 실시간으로 확인하는 '참조 없는 채점'을 쓴다. AI가 답변에 쓴 URL 링크가 살아 있는지, 발췌한 문장이 실제 본문과 일치하는지를 꼼꼼히 추적한다.
출처를 제시하는 능력은 정밀도, 재현율, F1 점수를 부분 점수 기준(소프트)과 완벽 일치 기준(하드)으로 나눈 4개 지표로 평가한다. 실패 원인을 분석할 수 있도록 계층별 세부 점수와 판정도 함께 제공한다.
최신 AI 모델들도 낙제점 기록
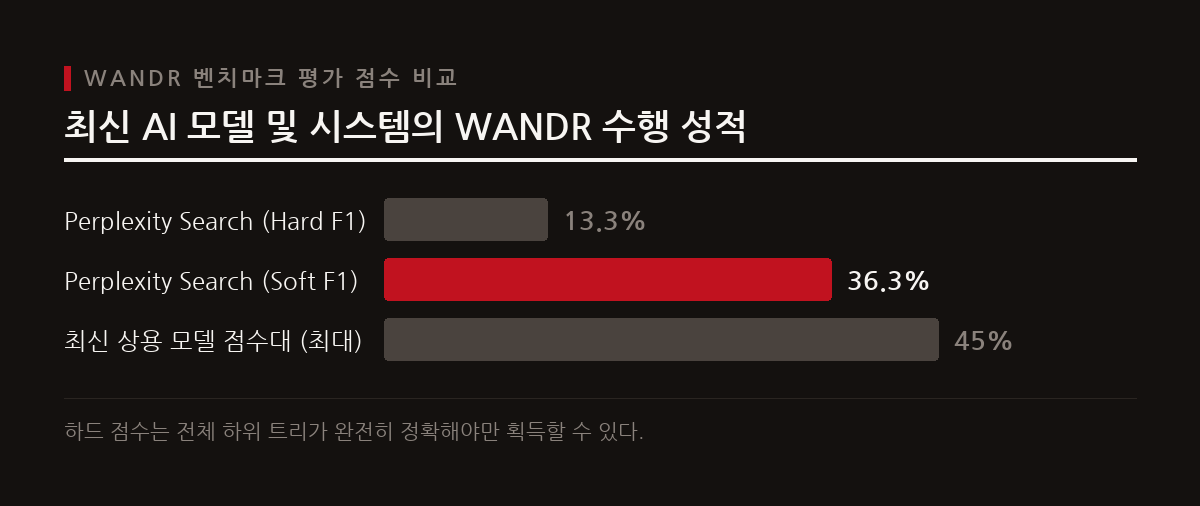
지금 시장을 이끄는 최첨단 AI 모델도 이 까다로운 검증 앞에서는 낙제점에 가까운 점수를 받았다. 퍼플렉시티의 자체 시스템은 소프트 F1 점수 36.3%, 하드 F1 점수 13.3%에 머물러 조사를 끝까지 완수하는 데 한계가 뚜렷했다.
GPT-5.6, Claude Fable 5, Gemini 3.5 같은 최고 사양 상용 모델들도 35~45% 수준에 그쳤다. 실시간 웹 환경에서 스스로, 믿을 만하게 조사를 끝마치는 일은 아직 제대로 풀리지 않은 과제다.
진짜 조사하는 AI가 가져올 변화
WANDR은 챗봇이 스스로 근거를 증명하는 자율형 리서치 에이전트로 나아가야 할 방향을 보여 준다. 다만 개인 투자자가 지금 당장 개별 기업 분석과 거시 정보 취합을 AI에 전적으로 맡기기에는 기술적 빈틈이 크다.
기술 기업들이 WANDR의 높은 문턱을 넘으며 에이전트의 검증 능력을 끌어올린다면, 시장의 투자 정보 비대칭은 크게 줄어들 것이다. 앞으로 리서치 시장의 주도권은 이 평가를 통과하는 기업에 돌아갈 가능성이 크다.
참고
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.