 유명한형제들
범용인공지능(AGI)을 향한 연구에서 연구실 안의 벤치마크 경쟁은 한계에 다다르고 있다. 최신 고성능 모델들은 정량 평가에서 높은 점수를 받지만, 실제 비즈니스 현장과 복잡한 사용자 환경에서는 예상하지 못한 장벽에 부딪힌다. 기술은 고립된 연구실보다 대규모 실제 서비스에서 사용자와 직접 부딪치며 피드백을 쌓아 가는 과정에서 발전한다.
구글 딥마인드의 AGI 개발 전략도 매개변수를 늘리거나 폐쇄적으로 연구하는 데 머물지 않는다. 이들이 앞세우는 것은 배포하고 상호작용하면서 배우는 실전형 접근이다. 인공지능을 실제 서비스에 붙이고 사용자 피드백을 받아 정렬하는 과정이 기술 발전을 이끌며, 실무 개발자에게도 앞으로 AI 모델을 어떤 방향으로 설계해야 할지 분명한 기준을 준다.
현장 배포로 완성하는 구글의 AGI 개발 전략
구글 딥마인드는 연구실 안에 갇힌 인공지능 대신, 실제 서비스에서 대규모 사용자와 상호작용하며 계속 나아지는 AGI를 만들려 한다. 코라이 카부쿠오글루 구글 딥마인드 수석부사장 겸 최고 AI 아키텍트는 AGI가 연구자만의 작업으로 끝나지 않고 사용자와 함께 만들어 가는 과정 속에서 실현된다고 본다. 실제 제품을 배포해 사용자 피드백과 신호를 모으고 이를 다시 모델 학습에 반영하는 순환 고리가 AGI 달성의 필수 요건이라는 설명이다.
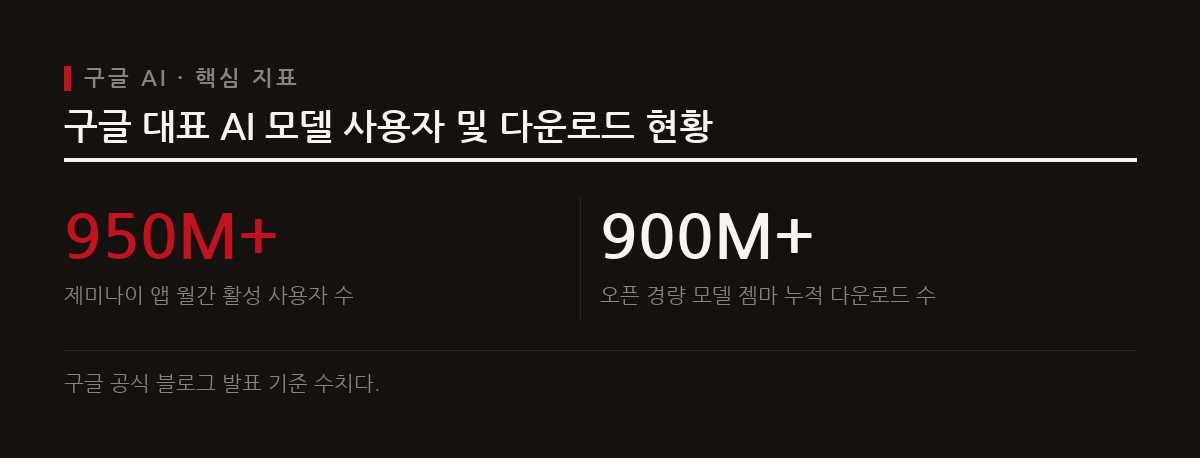
이 배포 전략은 구글의 거대한 AI 생태계가 있어 가능하다. 구글의 대표 인공지능 서비스인 제미나이(Gemini) 앱은 월간 활성 사용자 수(MAU)가 9억 5천만 명이 넘어 전 세계에서 폭넓은 피드백을 모으고 있다. 개발자를 겨냥한 구글 딥마인드의 오픈 경량 모델 제품군 젬마(Gemma)는 누적 다운로드 9억 회를 넘기며 전 세계 개발자 커뮤니티와 현장에서 성능을 검증받고 있다.
폐쇄적인 테스트 통과에 만족하지 않고 실제 시장과 개발 현장에 들어가 매일 쏟아지는 대규모 상호작용을 학습 재료로 삼는 구조가 구글이 생각하는 지속 가능한 AGI 개발 전략이다. 다양한 기기와 사용 환경에서 들어오는 실시간 신호는 실험실의 가상 데이터로 대신할 수 없는 자산이다.
단일 평가 공식이 없는 AGI와 사후학습의 역할
범용인공지능에 도달했는지 딱 잘라 판단해 주는 단일 벤치마크나 정해진 개발 공식은 없다. 카부쿠오글루 수석부사장은 특정 평가 도구에서 몇 점을 받았다고 해서 AGI에 도달했다고 단정할 수는 없다고 지적한다. 규격화된 시험 문제 몇 개로 기계가 인간 수준의 지능을 갖췄는지 판정하는 방식으로는 AGI에 필요한 유연성을 담아낼 수 없기 때문이다.
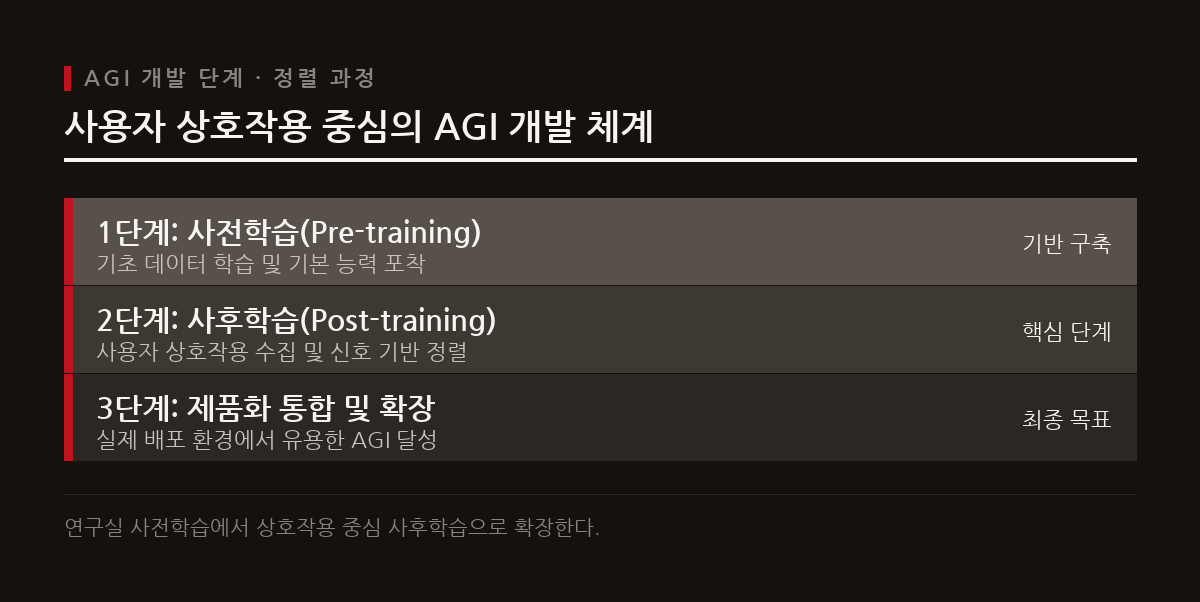
그래서 AGI의 실제 완성도는 뼈대를 만드는 사전학습(Pre-training) 이후의 사후학습(Post-training)과 제품화 통합 역량에서 갈린다. 사전학습이 방대한 데이터에서 언어와 지식의 패턴을 잡아내는 일이라면, 사후학습은 모델이 실제 사용자와 안전하고 효과적으로 소통하며 여러 업무를 정확히 해내도록 세밀하게 조정하는 과정이다.
구글 딥마인드는 사용자와의 상호작용 신호를 잡아 사후학습에 녹여 내는 개발 체계를 강화하고 있다. 모델이 실무 환경의 세부 맥락을 이해하고 그에 맞게 조율되는 단계를 거쳐야 인공지능이 쓸모 있는 생산성 도구이자 파트너가 되고, AGI에도 한 걸음 더 다가선다.
획일화를 경계하는 다양한 연구 탐색 체계
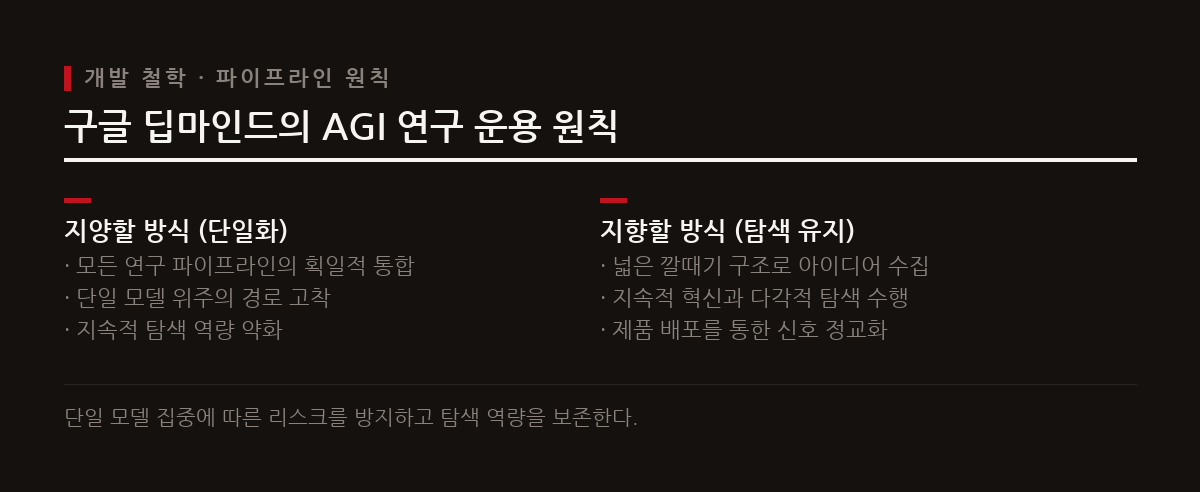
AGI를 개발하려면 연구 자원과 파이프라인을 특정 모델 하나나 경로 하나로 몰아서는 안 된다. 효율만 좇아 경로를 좁히다 보면 더 큰 혁신으로 이어질 수 있는 우연한 탐색 기회를 잃는다. 카부쿠오글루 수석부사장의 지적처럼, 복잡한 AGI 설계 과정에서 전체 프로세스를 서둘러 하나로 묶으면 오히려 탐색의 폭을 스스로 좁힐 위험이 크다.
이를 막기 위해 구글 딥마인드는 다양한 아이디어를 폭넓게 받아들이는 넓은 깔때기(large funnel) 구조를 만들어 연구 혁신과 탐색 역량을 유지하고 있다. 가능성 있는 여러 가설과 다양한 아키텍처 실험이 자유롭게 오갈 때 예측하지 못한 돌파구가 나오기 때문이다.
정교한 실행력이 필요한 대형 인공지능 개발 환경이라도, 실패를 두려워하지 않는 개방적인 탐색 풀을 유지해야 획일화의 함정을 피할 수 있다. 여러 변수와 접근 방식이 함께 굴러가는 유연한 운영 체계가 있어야 AGI 혁신 동력이 오래 이어진다.
개발자가 주목해야 할 상호작용 중심 AGI의 미래
구글 딥마인드의 행보는 현장 개발자들에게 벤치마크 점수만 좇는 개발 방식에서 벗어나라고 말한다. 연구실 안 가상 테스트 점수에 매달리기보다 실제 서비스와 연결해 실시간으로 들어오는 실전 데이터를 파악하는 데 집중해야 한다. 인공지능의 정렬과 발전은 사용자가 서비스와 만나는 접점에서 생기는 데이터 피드백 루프 안에서 이뤄지기 때문이다.
현장 개발자들은 이제 인공지능을 최종 통합하는 단계에서 사후학습을 어떻게 효과적으로 할지, 사용자 피드백을 제품 인프라에 어떻게 자리 잡게 할지 고민해야 한다. 가져다 쓰는 API 성능에만 기대지 말고, 사용자 행동을 의미 있는 상호작용 신호로 쌓아 모델 개선의 밑거름으로 쓰는 데이터 파이프라인 설계에 공을 들일 때다.
인프라 개선과 사후학습을 잘 연결하는 개발팀이 거대언어모델 환경에서 경쟁력을 먼저 갖출 수 있다. 구글이 거대한 제품 생태계로 AGI 로드맵을 현실로 옮기고 있듯, 현업 개발자들도 각자의 애플리케이션 환경에 맞는 피드백 루프를 자리 잡게 해 인공지능의 실제 효용을 높여야 한다.
참고
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.