 유명한형제들
인공지능 모델로 복잡하고 긴 개발 작업을 할 때 대화 맥락이 끊기거나 앞의 정보가 사라지는 현상은 개발 효율을 떨어뜨리는 주된 원인이었다. Codex CLI와 GPT-6 Astra는 이 오래된 컨텍스트 손실 문제를 줄이기 위해 함께 움직인다. 컨텍스트가 쌓이면서 생기는 문제를 다루는 새 노트 기반 관리 방식을 자세히 살펴본다.
Codex CLI, 긴 작업 대화 손실 문제에 대응하다
인공지능 모델로 길고 복잡한 개발 작업을 할 때 가장 자주 부딪히는 병목 가운데 하나가 대화 흐름의 유실이다. Codex CLI 0.153.4 버전은 긴 작업 중 세부 정보가 사라지는 문제를 해결하려고 실험적인 컨텍스트 관리 도구를 새로 넣었다. 기존 에이전트 도구들은 메모리 한계 때문에 대화가 길어지면 과거 맥락을 단순 요약해 처리했는데, 새 버전은 이 한계를 넘어 보려 한다.
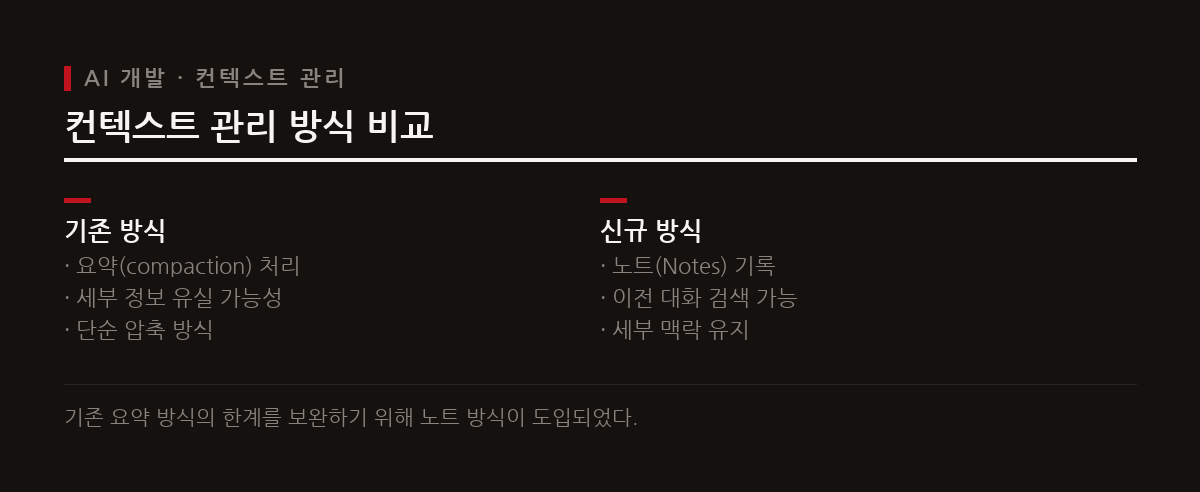
새로 추가된 컨텍스트 관리 방식은 대화 요약과는 전혀 다른 접근이다. 도표 '컨텍스트 관리 방식 비교' 그룹에서 보듯, 기존의 단순 요약 압축 방식과 새 노트 기반 검색 방식은 정보 보존력에서 분명한 차이가 난다. 이 기능은 OpenAI의 차세대 모델 GPT-6 Astra와 긴밀하게 연동되어 돌아가며, 대규모 코드 리팩토링이나 까다로운 시스템 디버깅처럼 오래 이어지는 작업의 생산성을 크게 높인다.
기존 LLM 컨텍스트 창 요약 방식의 한계
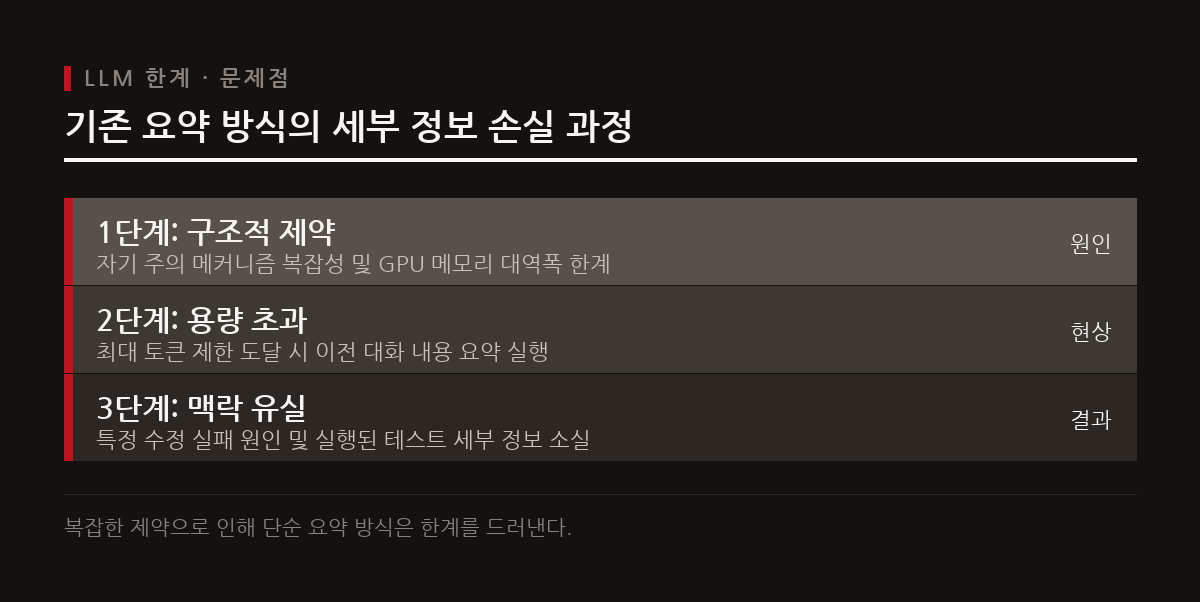
대규모 언어 모델의 컨텍스트 창 한계는 소프트웨어 구현 문제라기보다 트랜스포머 아키텍처 자체의 구조에서 나온다. 입력 토큰이 늘수록 연산량이 기하급수적으로 늘어나는 자기 주의 메커니즘의 O(n²) 복잡성과, GPU 자원을 크게 잡아먹는 KV 캐시 메모리의 제약이 물리적인 컨텍스트 크기 제한을 만든다. 그래서 한 번에 받아들일 수 있는 토큰 양은 제한될 수밖에 없다.
기존 요약 방식은 컨텍스트 창이 가득 차면 이전 대화를 압축해 빈 공간을 만들었다. 도표 '기존 요약 방식의 세부 정보 손실 과정'의 다단계 계층(tiers) 분석이 보여 주듯, 초기 입력에서 압축 단계를 거쳐 최종 정보 누락 단계에 이르는 동안 세부 정보가 크게 사라진다. 개발자가 겪은 특정 에러 원인이나 컴파일 결과, 테스트 코드의 구체적인 반환값 같은 세밀한 맥락이 요약 과정에서 걸러지기 일쑤였다. 그 결과 같은 디버깅 과정에서 인공지능이 예전에 시도했다가 실패한 오답을 계속 되풀이하는 심각한 오작동이 자주 생겼다.
GPT-6 Astra 노트 기반 컨텍스트 관리 구조
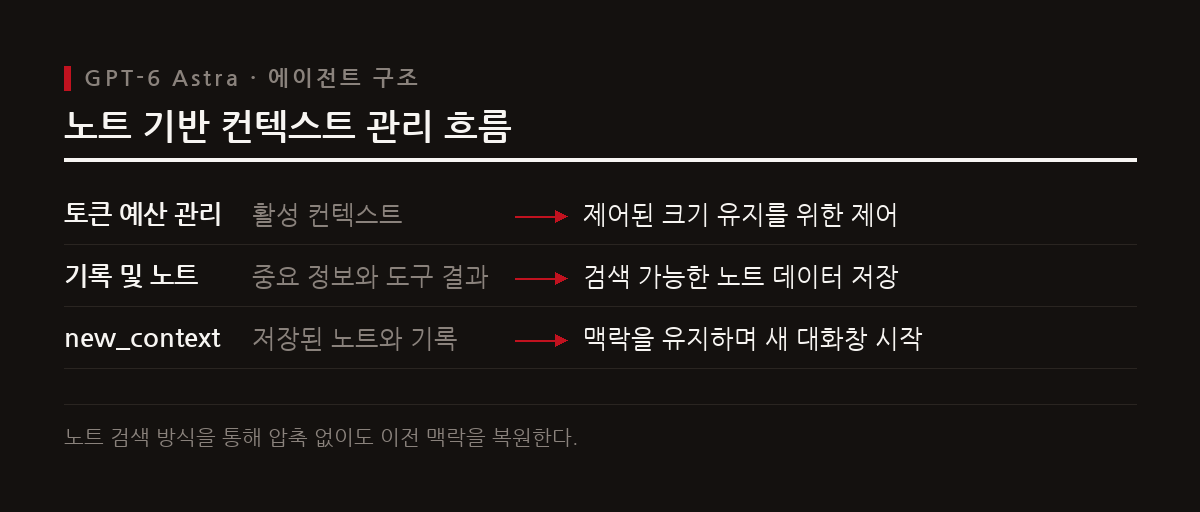
GPT-6 Astra는 기존의 거친 압축 방식 대신, 정보를 유연하게 기록하고 다시 배치하는 노트 기반 컨텍스트 관리 구조를 내놓았다. 이 구조는 토큰 예산 관리, 기록과 노트 작성, 새 컨텍스트 창 생성이라는 단계가 이어지며 돌아간다. 이를 통해 활성 컨텍스트 크기를 모델이 가장 빠르고 정확하게 처리할 수 있는 범위 안에 묶어 둔다.
정보 흐름은 도표 '노트 기반 컨텍스트 관리 흐름'에 나온 대로 차례로 진행된다. 먼저 토큰 예산 관리 단계에서 활성 컨텍스트를 정해 둔 크기 이하로 확실히 유지한다. 다음으로 대화 내용과 도구 실행 결과 가운데 핵심 정보를 요약본 대신 별도의 '노트'로 기록해 저장해 둔다. 마지막으로 new_context 기능을 실행해, 저장해 둔 노트와 이전 대화 기록은 그대로 둔 채 깨끗한 새 컨텍스트 창을 연다. 이렇게 하면 인공지능 에이전트는 쌓인 정보를 잃지 않으면서도 연산 부담을 최소로 줄일 수 있다.
설정 파일 편집을 통한 모드 활성화 방법
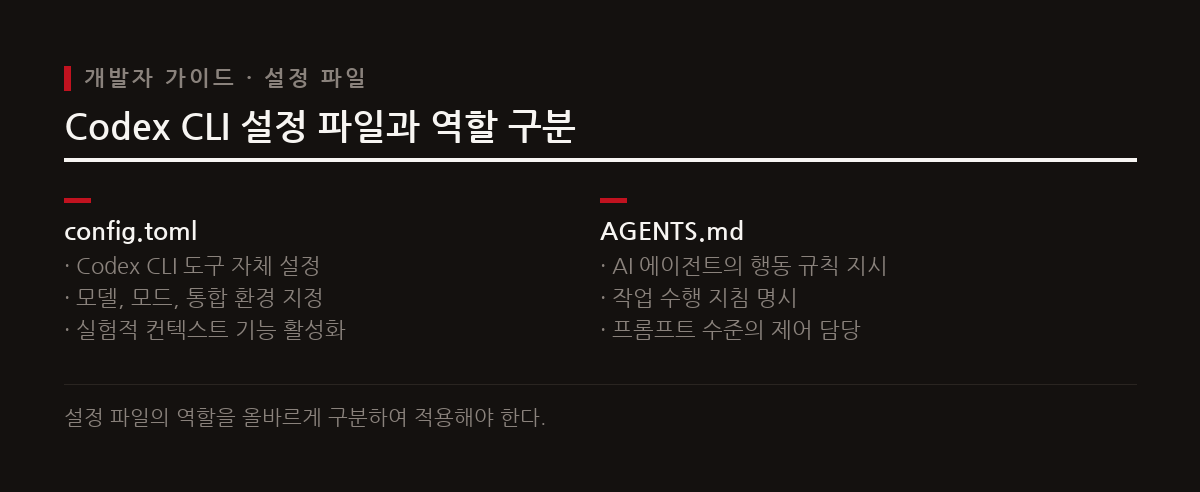
이 실험적 컨텍스트 관리 방식을 개발 환경에 적용하는 방법은 간단하다. 시스템 로컬 경로에 있는 사용자 설정 파일인 ~/.codex/config.toml 파일을 열어 몇 줄만 고치면 된다. 이 파일은 인공지능의 페르소나나 세부 작동 규칙을 정하는 다른 설정 파일들과는 성격이 다르다.
도표 'Codex CLI 설정 파일과 역할 구분' 그룹을 보면, AI의 행동 규칙과 프롬프트 지침을 넣는 AGENTS.md 설정 그룹과 CLI 도구 자체의 기술적 작동 사양을 정하는 config.toml 설정 그룹의 역할 차이를 분명히 알 수 있다. 새 기능을 켜려면 config.toml 안에 [features.context_management] 항목을 새로 선언하고, 바로 아랫줄에 experimental_mode = true 구문을 추가하기만 하면 된다. 이 설정을 마친 순간부터 Codex CLI는 새로 정의된 노트 기반 세션 관리를 실시간으로 실행한다.
장기 작업 AI 에이전트 개발을 위한 시사점
이렇게 바뀐 컨텍스트 관리 구조는 긴 개발 과정을 혼자 수행해야 하는 장기 작업 AI 에이전트가 어느 쪽으로 발전할지에 중요한 시사점을 준다. 개발자는 이제 큰 코드베이스를 다룰 때 컨텍스트가 끊기거나 앞선 분석 결과가 잊힐까 걱정하지 않아도 된다. 복잡한 디버깅 세션이나 수십 개 파일에 걸친 대규모 코드 구조 변경을 진행하는 중에도 핵심 맥락을 안정적으로 유지한 채 로직 구현에 집중할 수 있다.
이 실험적 기능은 지금 개발 환경에 바로 넣어 생산성 효과를 직접 확인해 볼 수 있는 쓸 만한 도구다. 인공지능 에이전트가 사람처럼 노트를 꾸준히 기록하고 메모리를 관리하는 방식은 앞으로 나올 여러 AI 보조 도구들의 기술 표준이 될 전망이다. 터미널을 열고 ~/.codex/config.toml 파일 설정을 고쳐 새 협업 환경을 직접 써 보면 된다.
참고
- Experimental Context Management / Compaction in Codex - Codex - OpenAI Developer Community
- What Changes When You Customize Your Configuration File? | The Complete Guide to Customizing Codex's config.toml|nobu AI agent manager
- Codex config.toml: Model, Proxy and Permissions Setup
- LLM context windows: what they are & how they work
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.