인공지능 기술이 발전함에 따라 다양한 시스템이 각기 다른 영역에서 활용되고 있다. 퍼플렉시티 컴퓨터와 딥마인드 알파스타는 모두 복잡한 연산을 수행하는 첨단 인공지능이지만, 적용되는 분야와 작동 방식에서 명확한 차이가 존재한다. 최근 일부 온라인상에서 퍼플렉시티의 시스템이 실시간 전략 게임을 플레이했다는 오해가 퍼지기도 했다. 하지만 게임 플레이와 관련된 성과는 구글 딥마인드의 알파스타에 해당하며, 퍼플렉시티 컴퓨터는 범용 디지털 작업자 플랫폼이다. 두 시스템의 실제 역량과 기술적 배경을 구체적인 사실을 바탕으로 구분해 살펴본다.
퍼플렉시티 컴퓨터와 스타크래프트의 오해
퍼플렉시티 컴퓨터는 2026년 2월에 공개된 다중 모델 기반의 범용 디지털 작업자 시스템이다. 이 시스템은 자연어 지시를 받아 복잡한 워크플로우를 계획하고 실행하도록 설계되었다. 일부 정보와 달리 퍼플렉시티 컴퓨터가 스타크래프트를 플레이했다는 내용은 사실이 아니며 확인되지 않는다. 실시간으로 게임을 진행하며 에이전트가 판단하는 동안에도 게임이 멈추지 않는 방식은 딥마인드의 알파스타 특징이다. 퍼플렉시티 컴퓨터와 알파스타는 각각 업무 자동화와 게임 정복을 목표로 개발된 서로 다른 기술 체계이다.
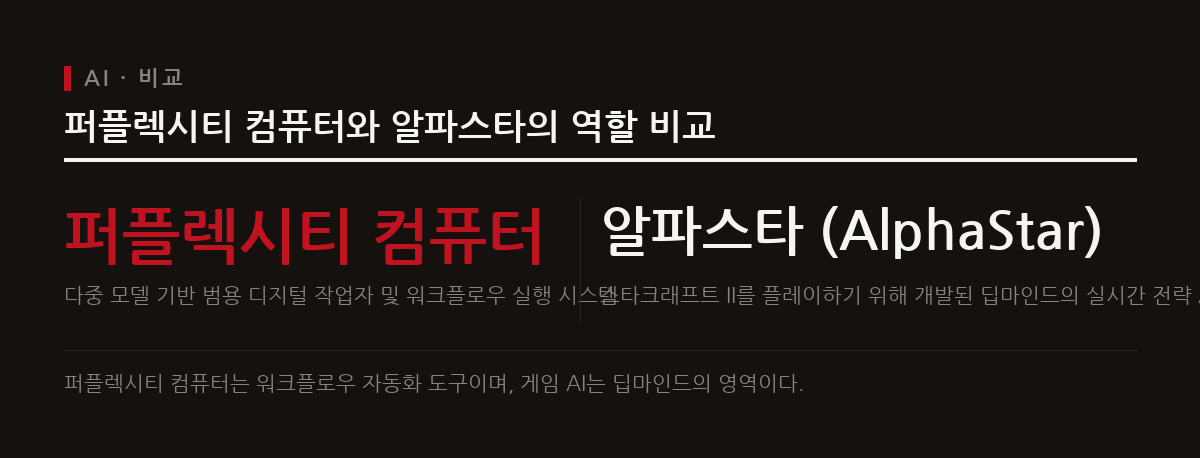
알파스타의 실시간 전략 게임 정복
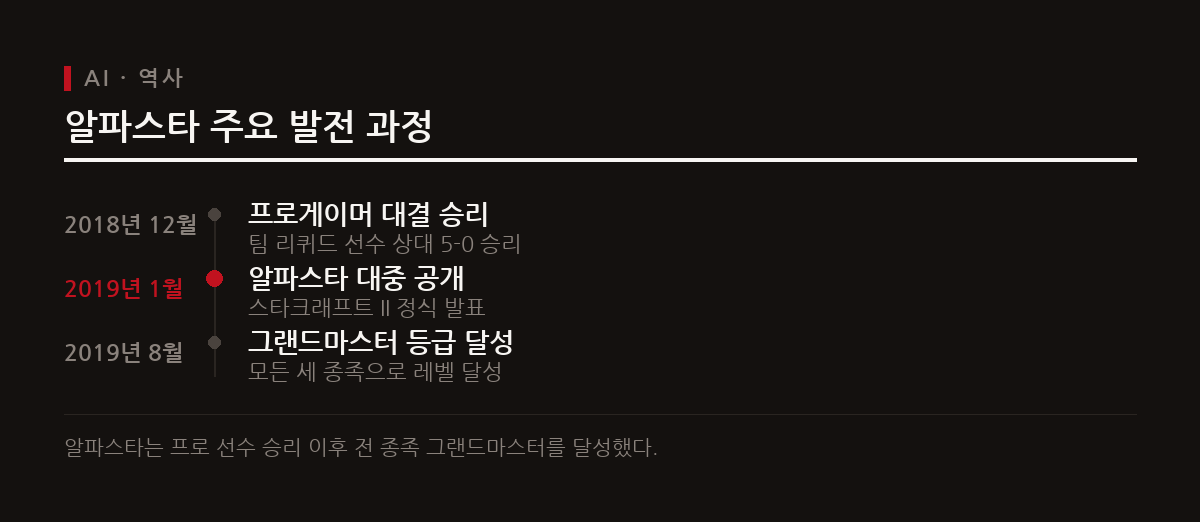
알파스타는 2018년 프로토스 프로 선수들을 상대로 승리하며 인공지능 연구의 중요한 이정표를 세웠다. 2018년 12월 팀 리퀴드 소속 선수를 상대로 첫 프로게이머 대결에서 승리했고, 2019년 8월 스타크래프트 II에서 그랜드마스터 등급에 도달하며 실력을 입증했다. 또한 Battle.net 플레이어의 99.8% 이상을 능가하는 순위를 기록하며 모든 종족에서 최고 수준에 올랐다. 이러한 성과는 바둑이나 체스를 넘어선 실시간 전략 게임 환경에서 인공지능이 거둔 기념비적인 결과다.
스타크래프트 환경의 기술적 도전 과제
스타크래프트는 시야 제한과 방대한 행동 공간 때문에 인공지능에게 매우 까다로운 실시간 환경이다. 체스와 달리 턴제가 아닌 실시간으로 진행되며 사고 정지 없이 게임이 계속 흐른다. 전체 맵을 볼 수 없고 정찰을 통해서만 정보를 얻는 부분 관측 가능성 조건이 적용된다. 매 순간 가능한 행동의 수가 약 10의 26승개에 달할 정도로 행동 공간이 방대하다. 에이전트는 이러한 제한 속에서 실시간으로 의사결정을 내려야 하므로 고도화된 학습 능력이 요구된다.

알파스타의 학습 방식과 멀티 에이전트 훈련
알파스타는 인간 플레이어 데이터로 지도 학습을 거친 뒤 자체 플레이를 통한 다중 에이전트 강화학습으로 진화했다. 블리자드의 익명화된 인간 플레이어 데이터를 이용한 지도 학습으로 기본 전략을 익혔다. 자체 플레이를 진행하는 알파스타 리그를 통해 다양한 경쟁자들과 대결하며 훈련했다. 강화학습을 결합하여 복잡하고 유연한 전략을 스스로 발전시켰다. 이 과정을 통해 인간의 직관을 모방하는 것을 넘어 독창적인 전술을 구사하는 단계로 도약했다.

퍼플렉시티 컴퓨터의 실제 업무 자동화 역량
퍼플렉시티 컴퓨터는 자연어 지시로 서브 에이전트를 배포해 웹 검색과 문서 생성을 수행하는 에이전트 플랫폼이다. 사용자가 자연어로 작업을 지시하면 여러 서브 에이전트가 협력하여 작업을 수행한다. 웹 검색, 문서 생성, 데이터 처리 및 API 호출 등 복잡한 워크플로우를 처리한다. 수 시간에서 수개월 동안 지속되는 장기 작업 흐름도 생성 및 실행할 수 있다. 개발자와 실무자는 이 플랫폼을 활용해 복잡한 디지털 업무 프로세스를 자동화할 수 있다.
참고
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.