인공지능 기술은 방대한 데이터 학습과 추론 능력을 바탕으로 다양한 산업 분야에서 혁신을 이끌고 있다. 그러나 최신 대규모 언어 모델 역시 자신감 있게 틀린 답을 내놓는 환각 현상을 보이며 상식 수준의 인과 관계를 이해하지 못하는 한계를 드러낸다. 이러한 문제를 해결하기 위해 연구자들은 인간 피드백 기반 강화학습과 미세 조정, 장기 강화학습 등 정교한 최적화 기법을 도입하고 있다. 객관적인 벤치마크 평가를 통해 AI 모델의 지능을 지속적으로 향상시키는 최신 인공지능 기술의 원리와 발전 방향을 살펴본다.
인공지능의 본질과 한계점
인공지능은 데이터 속 패턴을 학습하여 인간의 지적 과업을 수행하지만 여전히 치명적인 한계를 안고 있다. 대표적인 문제는 대규모 언어 모델(LLM)이 문법적으로 완벽하면서도 사실과 다른 거짓 정보를 자신감 있게 생성하는 환각(hallucination) 현상이다. 또한 AI는 인간이 상식적으로 파악하는 세상의 인과 관계를 이해하지 못한다. 예컨대 GPT-3에 토스터 기기와 연필 중 어느 것이 더 무겁냐고 질문했을 때 연필이 더 무겁다고 답하는 식의 상식 추론 오류를 범하기도 한다. 이러한 기술적 한계와 고품질 데이터의 부족 문제는 데이터 정확도가 생명인 의료, 법률, 금융 등 민감한 민간 및 공공 분야에 생성형 AI를 도입하는 데 커다란 장벽으로 작용한다.

환각 현상의 주요 원인 분석
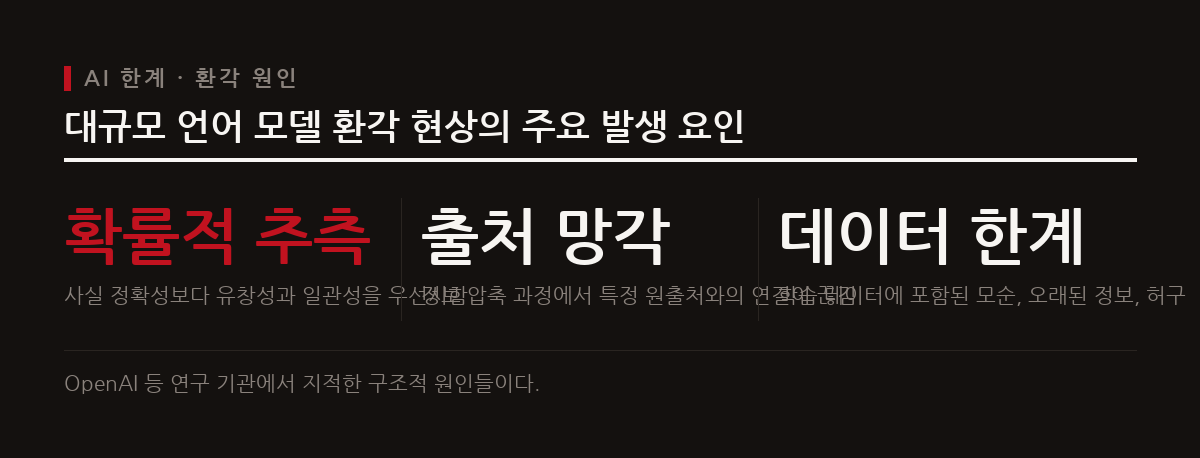
언어 모델에서 환각이 발생하는 주요 요인은 크게 세 가지로 나뉜다. 첫째, 모델이 사실관계의 검증보다 문장의 유창성과 일관성을 우선시하여 확률적 추측을 수행하기 때문이다. 둘째, 사전 학습 데이터 자체에 들어 있는 모순이나 오답, 허구의 정보가 모델의 출력에 그대로 반영되기 때문이다. 셋째, 모델이 파라미터 가중치 형태로 지식을 압축하는 과정에서 특정 정보의 원본 출처를 잊어버리는 출처 망각 현상이 일어난다. 오픈AI 등의 연구에 따르면 학습과 평가의 인센티브 구조 자체가 이러한 환각을 유발하기도 하므로 정교한 데이터 검증과 손실 구조 개선이 요구된다.
인공지능의 성능을 높이는 학습 방법
인공지능은 수많은 문서, 사진, 음성 데이터를 입력받아 내부 규칙과 패턴을 스스로 탐색하며 성능을 높인다. 입력 데이터의 양과 질이 확보될수록 판단의 정확도는 비례하여 향상된다. AI의 핵심 구조인 인공 신경망은 인간의 뇌 신경망을 모방한 노드 층으로 구성되며, 이 층을 깊게 쌓아 복잡한 패턴을 익히는 과정을 딥러닝이라 부른다. 모델은 예측값과 실제 정답 사이의 오차를 나타내는 손실 함수(Loss Function)를 활용하여 스스로 오답을 평가하고, 이를 최소화하도록 가중치를 반복 조정하는 최적화 과정을 거쳐 정확도를 다듬어 나간다.

핵심 AI 고도화 기법 비교
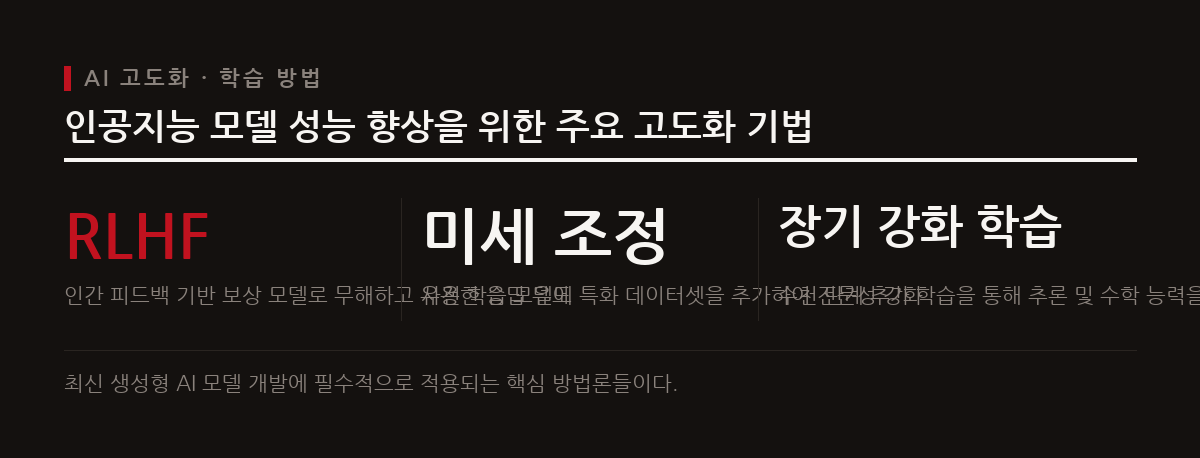
AI 모델의 한계를 극복하고 특정 과업 수행력을 극대화하기 위해 다각도의 고도화 기법이 적용된다. 첫째, 인간 피드백 기반 강화학습(RLHF)은 인간의 선호도를 반영한 보상 모델을 구축하여 유용하고 무해한 콘텐츠를 생성하도록 모델 정책을 최적화한다. 둘째, 미세 조정(Fine-tuning)은 특정 도메인이나 작업에 맞춰 엄선된 데이터셋을 추가 학습시킴으로써 특화된 문제 해결 능력을 부여한다. 셋째, NVIDIA Research가 선보인 ProRL v2와 같은 장기 강화학습 기법은 수천 단계 이상의 강화학습을 지속하여 수학, 코딩, 복합 추론 영역에서 모델의 성능 한계를 대폭 확장한다.
AI 성능 평가와 벤치마크의 활용
인공지능 모델의 성능을 정밀하게 측정하기 위해 표준화된 AI 벤치마크 평가 체계가 활용된다. 벤치마크는 자연어 처리부터 추론, 코딩, 수학 등 다채로운 영역에서 모델 간 알고리즘 성능을 객관적으로 비교하는 데이터셋이다. 한국어 환경에서는 인문학부터 STEM 과목까지 45개 분야 35,030개 문항으로 구성된 KMMLU 벤치마크가 대표적인 멀티태스크 언어 이해 평가 기준으로 쓰인다. 이러한 평가 과정에서는 정확성과 유창성뿐만 아니라 편향 감지와 사용자 신뢰도까지 종합적으로 측정하며, 자동 평가 지표와 인간 평가 방식을 병행해 지능을 검증한다.
참고
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.