 유명한형제들
OpenAI에서 ChatGPT와 RLHF 개발을 이끌었던 디오고 알메이다가 세운 TypeSafe AI가 새로운 개념의 AI 모델 Jev를 공개했다. 기존 대규모 언어 모델(LLM)은 문장을 차례로 생성하지만, Jev는 정형화된 선택지와 확률을 한 번의 병렬 처리로 계산하는 시스템 원(System One) 의사결정 모델이다. 텍스트를 내놓지 않으니 환각 현상이 생기지 않고, 실시간 에이전트 연동에 맞춰져 있다. Jev의 개발 배경과 작동 방식, 기존 LLM과 비교한 속도와 비용을 살펴본다.
OpenAI 출신 연구원의 새로운 도전, Jev 공개
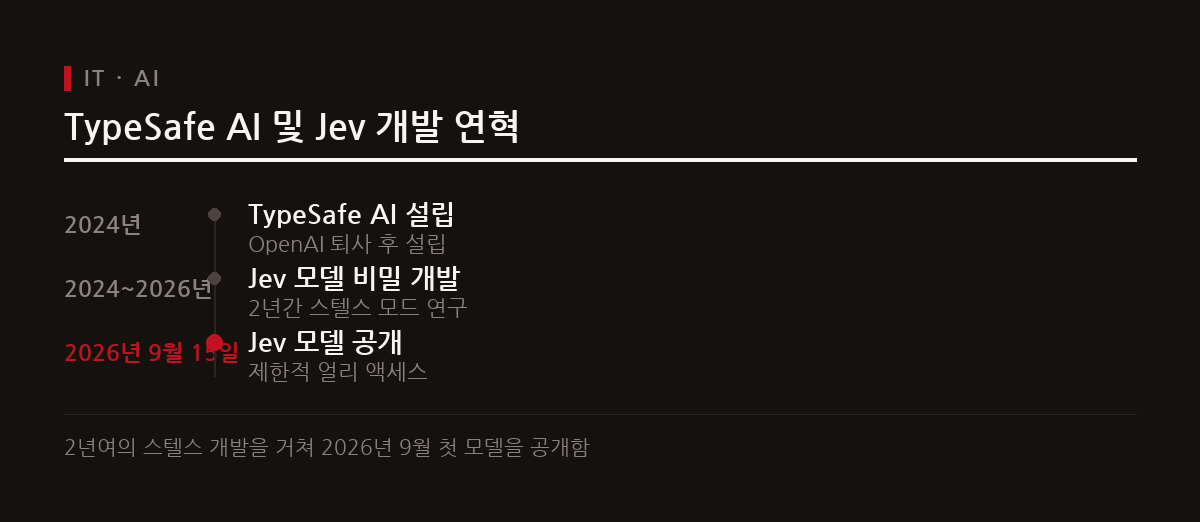
디오고 알메이다(Diogo Almeida)는 OpenAI에서 InstructGPT, ChatGPT, GPT-4 개발과 RLHF(인간 피드백 기반 강화 학습)를 주도한 연구원이다. 그는 2024년 OpenAI를 떠나 TypeSafe AI를 세웠고, 기존 대규모 언어 모델의 구조적 한계를 넘겠다며 약 2년간 외부에 알리지 않고 개발을 이어 갔다.
그 결과 TypeSafe AI는 2026년 9월 15일 의사결정 전용 모델 Jev의 제한적 얼리 액세스를 정식으로 시작했다. 대화나 문장 생성을 목적으로 하는 프론티어 LLM과 달리, Jev는 소프트웨어와 AI 에이전트 내부의 통제와 판단을 위해 설계한 시스템 원 모델을 내세운다.
텍스트 생성을 배제한 시스템 원 의사결정 모델
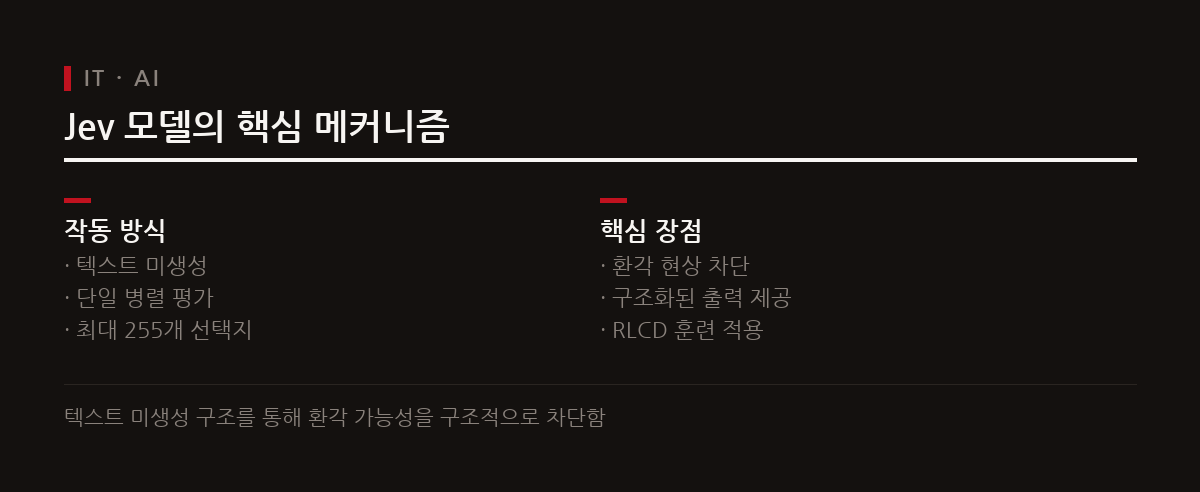
Jev가 기존 모델과 가장 다른 점은 문장을 토큰 단위로 차례로 만드는 자기회귀(Autoregressive) 방식을 쓰지 않는다는 것이다. 주어진 상태와 질문, 선택지에 대한 확률을 모두 한 번의 병렬 처리로 계산한다. 텍스트 생성을 아예 빼고 유형화된 데이터와 신뢰도 점수, 확률 추정치만 내놓기 때문에 구조상 환각 현상이 생기지 않는다.
훈련에는 RLCD(Reinforcement Learning for Calibrated Decisions)라는 자체 방식을 썼다. 요청 하나에서 최대 255개의 정형화된 선택지 가운데 가장 알맞은 답을 골라낸다. 대화형 인터페이스 없이 정형화된 판단만 필요한 시스템 파이프라인에서는 정확도가 특히 높다.
기존 LLM 대비 압도적인 속도와 비용 효율성
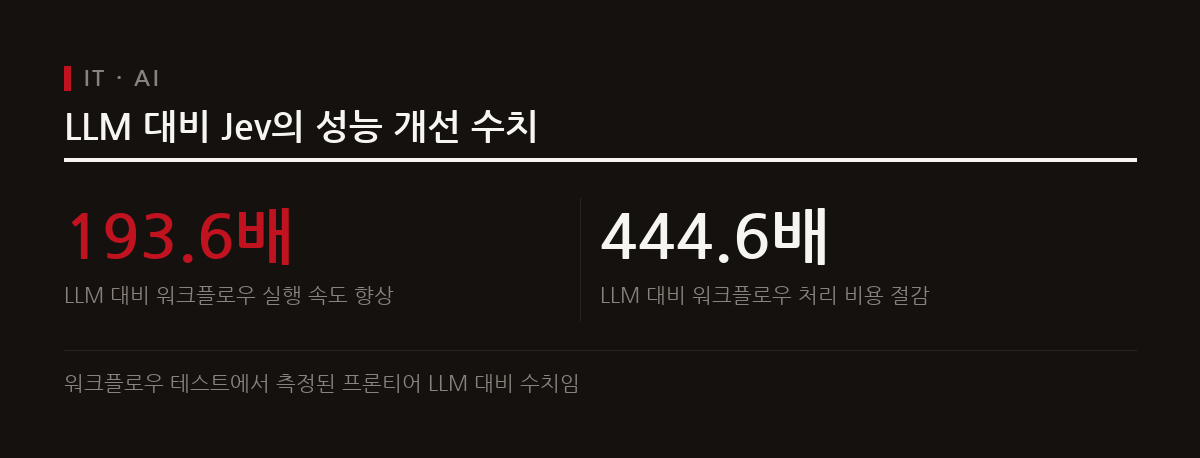
Jev는 실제 워크플로우 테스트에서 기존 대규모 언어 모델보다 훨씬 좋은 수치를 냈다. 실제 워크플로우 실행 기준으로 기존 LLM보다 193.6배 빨랐고, 비용은 444.6배 낮았다. 작업 조건에 따라 프론티어 LLM보다 추론이 20배에서 200배 빠르고 비용은 40배에서 400배 싸다.
이 정도 속도와 비용이면 AI 에이전트 아키텍처를 만들 때 지연 시간을 크게 줄일 수 있다. 정형화된 의사결정을 빠르게 처리하므로 시스템 병목을 푸는 데도 도움이 된다.
파격적인 가격 정책과 고성능 추론 능력
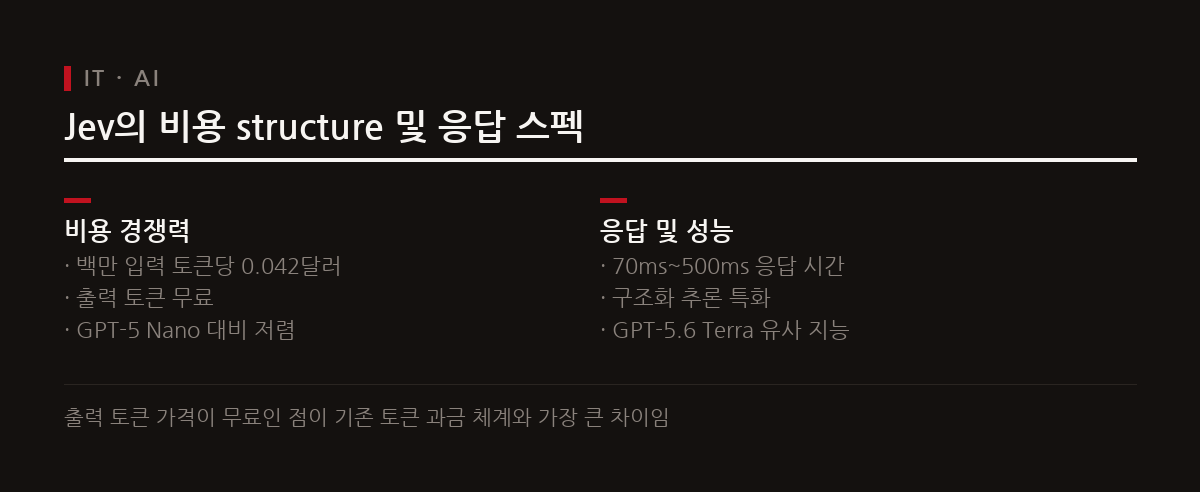
TypeSafe AI는 Jev 가격을 백만 입력 토큰당 0.042달러로 정했다. 백만 토큰당 0.05달러인 OpenAI GPT-5 Nano보다 싸다. 텍스트를 출력하지 않는 모델이라 출력 토큰 비용은 받지 않으니, 개발자의 부담은 그만큼 더 줄어든다.
응답 시간은 최소 70밀리초에서 최대 500밀리초 수준이어서 실시간 시스템 통제에 쓰기 좋다. 지능 면에서도 구조화된 의사결정 작업에서는 GPT-5.6 Terra의 기본 추론 설정과 대체로 비슷한 추론 정확도를 보인다.
개발자를 위한 의사결정 모델의 새로운 지평
Jev가 나오면서 복잡한 AI 파이프라인을 만드는 개발자는 아키텍처를 다르게 짤 수 있게 됐다. 에이전트 시스템이 텍스트를 따로 파싱하지 않고 유형화된 값과 신뢰도 점수만 받아 바로 로직을 실행할 수 있기 때문이다. 환각이 없고 출력이 구조화돼 있어 시스템 내부의 로깅, 분류, 경로 제어 작업에 잘 맞는다.
앞으로 AI 아키텍처는 사용자 인터페이스에는 대화형 LLM을, 내부 시스템 판단에는 Jev 같은 의사결정 모델을 붙이는 구조로 갈 가능성이 높다. 이렇게 나누면 비용과 추론 속도, 시스템 안정성을 함께 챙긴 AI 서비스를 만들 수 있을 것이다.
참고
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.