로컬 PC에서 대규모 언어 모델을 간편하게 구동할 수 있는 오픈소스 플랫폼 Ollama가 의사결정 모델을 새로 지원한다. 버전 0.35 이상부터 제공되는 이 기능은 긴 문장을 생성하는 기존 LLM과 달리 정해진 선택지나 확률을 빠르게 판단하는 데 특화되어 있다. 텍스트 분류와 모델 라우팅 등 실시간 판단이 중요한 백엔드 개발자들에게 새로운 로컬 AI 구동 환경이 열렸다.
로컬 LLM 플랫폼 Ollama의 새로운 진화
Ollama는 사용자가 대규모 언어 모델(LLM)을 로컬 PC 환경에서 쉽게 실행하고 관리하도록 돕는 오픈소스 플랫폼이다. 최근 출시된 Ollama 0.35 이상 버전부터 TypeSafe AI의 Jev API를 기반으로 한 의사결정 모델 지원이 본격적으로 시작되었다.
기존 LLM이 문맥을 이해하고 길고 복잡한 답변을 순차적으로 생성하는 방식이었다면, 이번에 들어온 의사결정 모델은 미리 주어진 선택지 중에서 가장 적절한 답을 빠르게 골라낸다. 개발자는 /v1/systemone API 엔드포인트를 호출하여 로컬 환경에서 즉각적인 의사결정 기능을 구현할 수 있다. 긴 문장 생성이 불필요한 백엔드 로직이나 분류 작업에서 속도와 효율성을 크게 높인다.

빠른 판단에 특화된 System One 모델
의사결정 모델은 대니얼 카너먼의 개념인 '빠른 생각과 느린 생각'에서 영감을 받아 설계된 System One 범주의 모델이다. 순간적인 판단과 직관적 선택에 집중하도록 만들어져 출력 토큰 생성을 최소화한다.
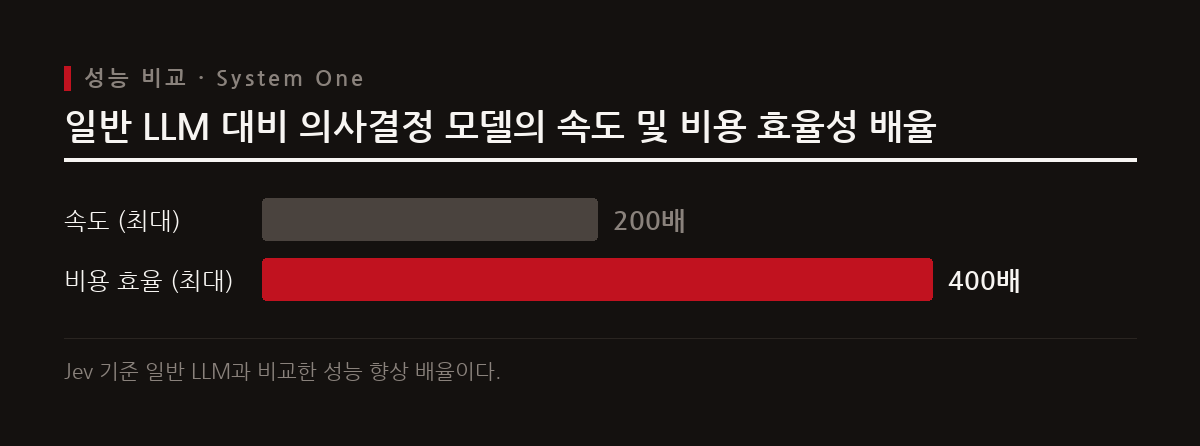
이 모델은 일반적인 LLM 대비 20배에서 200배 빠른 속도를 보이며, 비용 면에서도 40배에서 400배 저렴한 효율성을 자랑한다. 또한 Choice(선택), Score(점수), Noul(참/거짓 확률) 세 가지 판단 방식을 지원하여 세밀한 평가가 가능하다. 한 번의 API 요청으로 최대 64개의 질문을 병렬 처리할 수 있어, 질문 수가 늘어나도 응답 시간 지연이 적다.
Ollama에서 실행 가능한 주요 의사결정 모델들
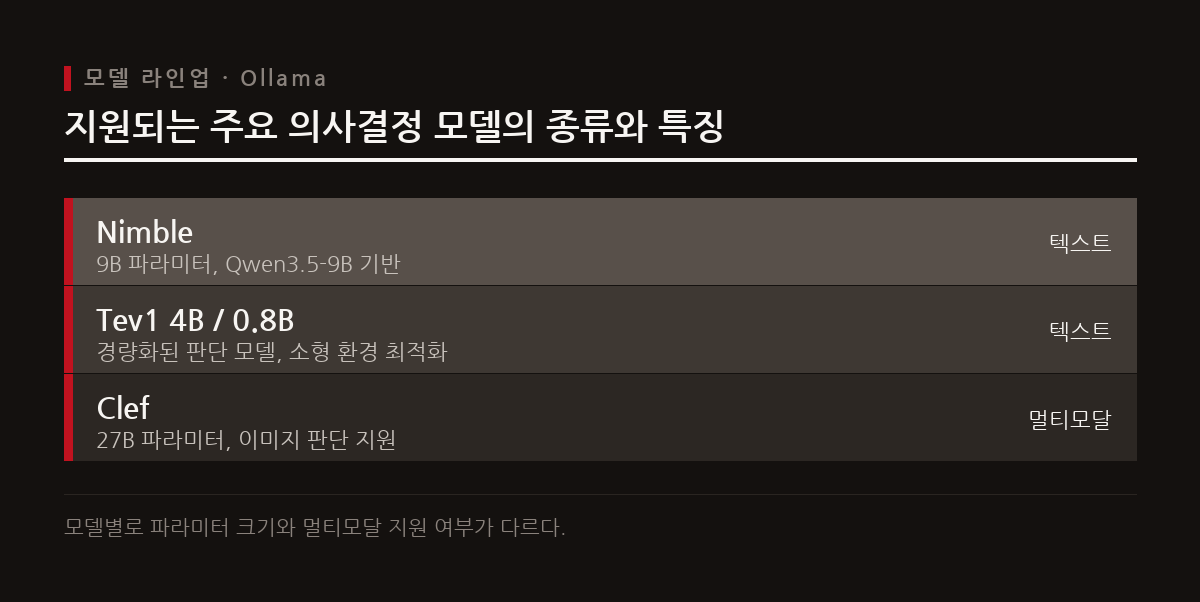
Ollama 환경에서는 사용 목적과 하드웨어 스펙에 맞춘 다양한 의사결정 모델을 구동할 수 있다. 대표적으로 Nimble은 Qwen3.5-9B 기반의 9B 파라미터 모델로, MacBook Pro M5 Max 기준 100ms 미만의 응답 시간을 달성한다. RAM 요구량은 9.3GB에서 9.5GB 수준이다.
Tev1 계열은 Qwen3.5-4B 기반의 Tev1 4B 모델과 메모리 제약 환경용 812MB 크기의 Tev1 0.8B 모델을 제공한다. 참고로 Tev1 4B의 VRAM 요구량은 Q4_K_M 양자화 기준 약 4GB로 알려져 있으나 일부 자료에서는 9.3GB로 기재되는 등 출처별 차이가 존재한다. 한편 Clef는 Qwen3.8-27B 기반의 27B 파라미터 멀티모달 모델로, 텍스트와 이미지를 함께 판단할 수 있으며 Ollama 0.35.1 이상이 필요하다.
로컬 의사결정 모델의 활용과 전망
로컬 의사결정 모델의 도입은 실시간 판단이 필수적인 인프라 구축에 큰 변화를 가져온다. 사용자 문의의 자동 분류, 작업 난이도에 따른 AI 모델 라우팅, 유해 콘텐츠 검수 등 빠르게 결과를 도출해야 하는 백엔드 시스템에 즉시 적용이 가능하다.
클라우드 API를 호출하지 않고 로컬 PC에서 처리하므로 호출 비용을 아낄 수 있으며, 민감한 내부 데이터를 외부로 전송하지 않아 보안성도 뛰어나다. Jev 자체의 정확한 파라미터 규격은 공개된 정보에서 확인되지 않았으나, Ollama 0.35 이상 환경을 구축한 개발자라면 라이브러리에 등록된 모델을 다운로드받아 바로 프로젝트에 접목할 수 있다.

참고
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.