대규모 언어 모델(LLM)과 AI 에이전트 개발에 웹 데이터는 필수적이다. 그러나 복잡한 웹 페이지를 AI 학습용으로 정제하는 과정은 많은 시간과 노력을 요구한다. Crawl4AI는 이러한 문제를 해결하는 오픈소스 비동기 웹 크롤러이다. 웹 페이지를 AI 친화적인 마크다운 형태로 변환하여 AI 개발 효율을 높이는 데 기여한다.
Crawl4AI: AI 개발자를 위한 웹 크롤러
Crawl4AI는 대규모 언어 모델(LLM), 검색 증강 생성(RAG), AI 에이전트 파이프라인에 최적화된 오픈소스 비동기 웹 크롤러이다. 이는 복잡한 웹 페이지에서 불필요한 HTML 태그와 광고, 내비게이션을 걸러내 AI 친화적인 마크다운으로 데이터를 정제한다.
정제된 마크다운은 표, 코드 블록, 인용 링크 등 원본 콘텐츠의 핵심 구조를 손실 없이 보존한다. 이로써 AI 모델이 웹 페이지의 의미론적 내용을 정확히 파악하고 활용하는 데 도움을 준다.
쉬운 설치와 비용 없는 오픈소스 접근
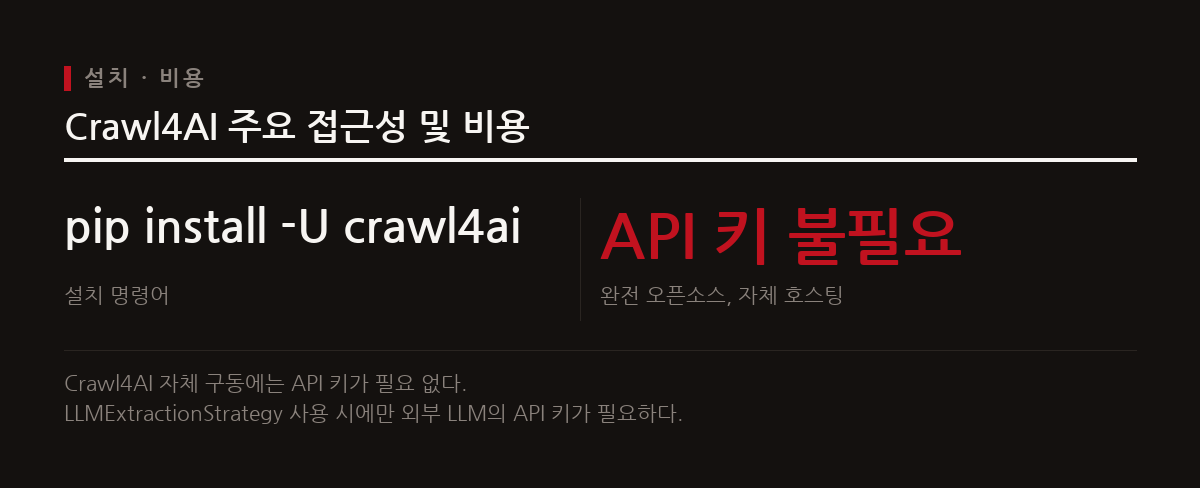
Crawl4AI는 파이썬 패키지 인덱스(PyPI)를 통해 pip install -U crawl4ai 명령어로 간단히 설치된다. 이 쉬운 설치 방식은 개발자들의 프로젝트 통합을 돕는다.
이 도구는 완전한 오픈소스이며, 별도의 회원가입이나 필수 API 키 없이 로컬에서 구동된다. LLM 모델 연동 시에만 해당 API 키가 필요하다. Crawl4AI는 완전 오픈소스이며, pip를 통한 쉬운 설치, 그리고 필수 API 키나 회원가입이 불필요한 비용 없는 접근성을 제공한다.
AI 학습을 위한 콘텐츠 정제와 동적 웹 제어
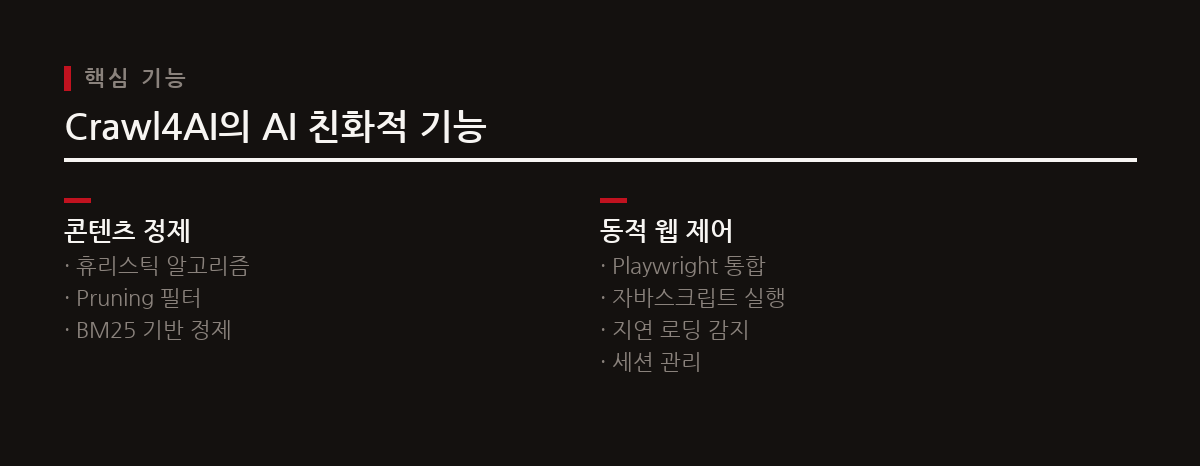
Crawl4AI는 AI 학습에 적합한 웹 콘텐츠를 위해 휴리스틱 알고리즘, Pruning 필터, BM25 알고리즘 기반 정제로 불필요한 정보를 효과적으로 걸러낸다. 이 필터링은 AI 모델이 집중할 본문 내용을 정확하게 추출한다.
또한 Playwright를 활용하여 자바스크립트 렌더링, 무한 스크롤, 지연 로딩 페이지 등 동적 웹 페이지를 완벽하게 제어한다. Crawl4AI는 휴리스틱 및 BM25 알고리즘 기반 정제, Playwright를 통한 동적 웹 제어, 사용자 정의 자바스크립트 실행, 세션 관리 등 AI 친화적 기능을 제공한다.
효율적인 다중 페이지 및 딥 크롤링 전략
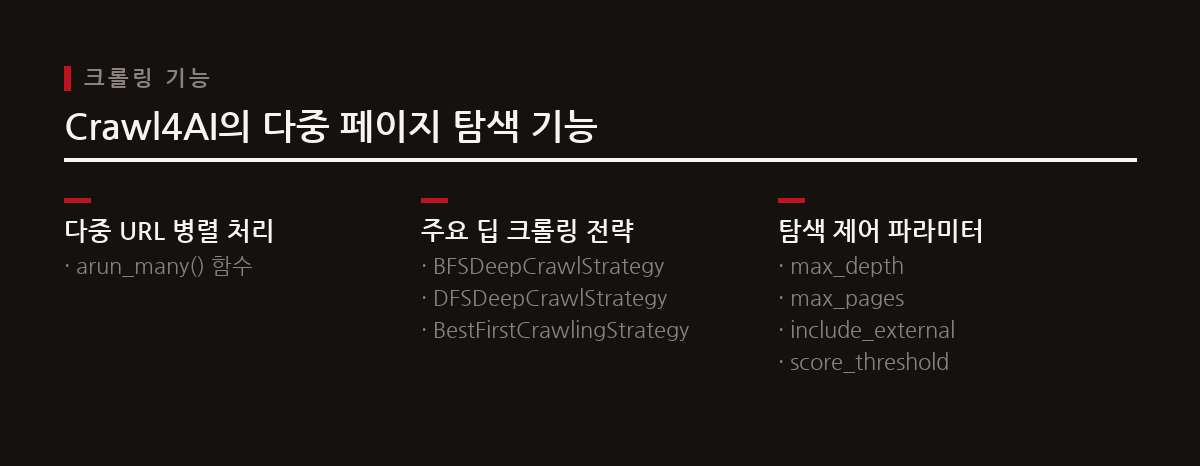
Crawl4AI는 단일 페이지를 넘어 웹사이트 전체를 효율적으로 탐색한다. arun_many() 함수로 다수의 URL을 병렬 처리하여 대규모 웹 데이터를 빠르게 수집한다.
max_depth, max_pages 같은 파라미터로 탐색 깊이와 수집 페이지 수를 세밀하게 제어한다. 너비 우선(BFS), 깊이 우선(DFS), 관련도 기반(Best-First) 등 다양한 딥 크롤링 전략을 선택할 수도 있다. Crawl4AI는 arun_many() 병렬 처리, max_depth와 max_pages 제어, BFS, DFS, Best-First 딥 크롤링 전략 등 다중 페이지 탐색 기능을 지원한다.
AI 개발 생산성 향상을 위한 핵심 도구
Crawl4AI는 복잡한 웹 스크래핑 및 데이터 정제 작업을 자동화하여 AI 개발자의 생산성을 크게 향상한다. 웹 페이지에서 필요한 데이터를 수집하고 LLM이 바로 활용할 고품질 마크다운으로 변환하는 과정을 간소화한다.
이 도구는 번거로운 웹 브라우저 제어와 정교한 데이터 필터링 작업을 효율적으로 처리한다. AI 에이전트나 LLM이 인터넷을 탐색하고 정보를 수집해야 하는 시나리오에서 안정적이고 신뢰할 수 있는 데이터 공급원 역할을 수행한다.
참고
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.