 유명한형제들
대규모 언어 모델(LLM)과 AI 에이전트를 개발하려면 웹 데이터가 있어야 한다. 그런데 복잡한 웹 페이지를 AI 학습용으로 정제하는 데는 시간과 손이 많이 간다. Crawl4AI는 이 일을 맡는 오픈소스 비동기 웹 크롤러다. 웹 페이지를 AI가 다루기 쉬운 마크다운으로 바꿔 AI 개발 효율을 높여 준다.
Crawl4AI: AI 개발자를 위한 웹 크롤러
Crawl4AI는 대규모 언어 모델(LLM), 검색 증강 생성(RAG), AI 에이전트 파이프라인에 맞춰 만든 오픈소스 비동기 웹 크롤러다. 복잡한 웹 페이지에서 불필요한 HTML 태그와 광고, 내비게이션을 걸러 내고, AI가 읽기 좋은 마크다운으로 데이터를 정리한다.
정제된 마크다운에는 표, 코드 블록, 인용 링크 같은 원본 콘텐츠의 구조가 손실 없이 남는다. 덕분에 AI 모델이 웹 페이지의 내용을 정확히 파악하고 활용할 수 있다.
쉬운 설치와 비용 없는 오픈소스 접근
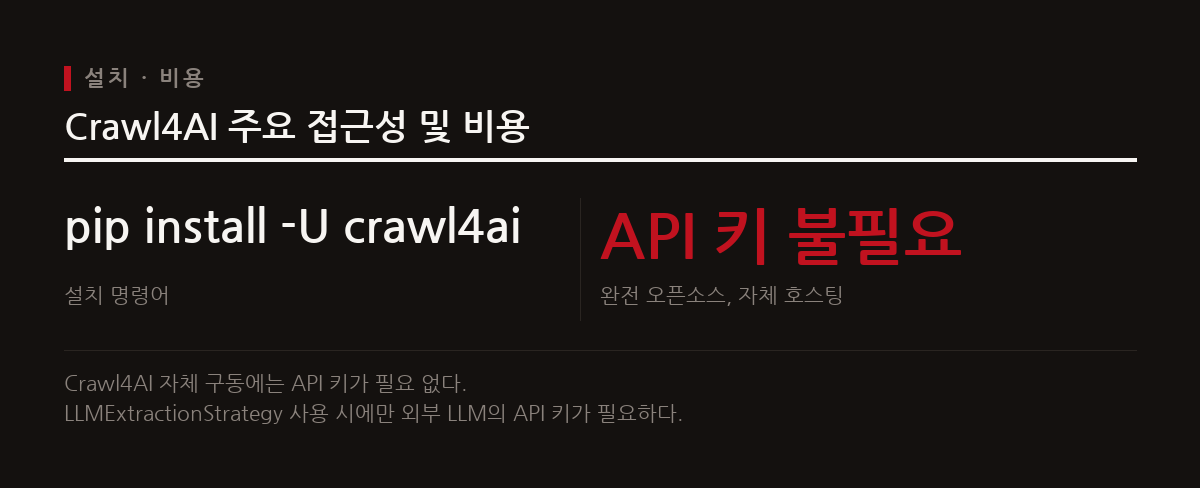
Crawl4AI는 파이썬 패키지 인덱스(PyPI)에 올라 있어 pip install -U crawl4ai 명령 한 줄로 설치된다. 설치가 이렇게 간단하니 기존 프로젝트에 붙이기도 편하다.
완전한 오픈소스이고, 회원가입이나 필수 API 키 없이 로컬에서 돌아간다. API 키는 LLM 모델을 연동할 때만 필요하다. 정리하면 pip로 설치하고, 가입이나 키 없이 비용을 들이지 않고 바로 쓸 수 있는 도구다.
AI 학습을 위한 콘텐츠 정제와 동적 웹 제어
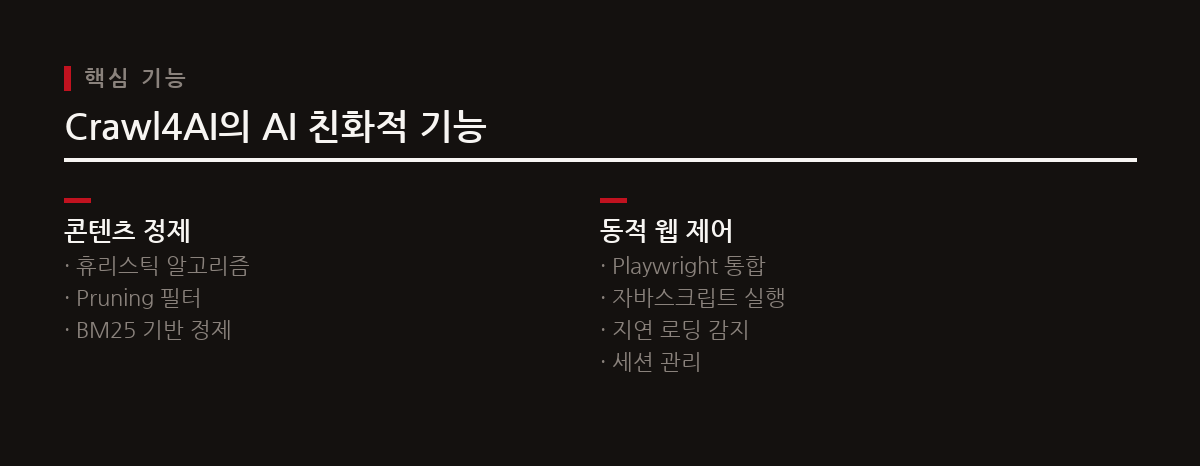
AI 학습에 맞는 콘텐츠를 얻기 위해 Crawl4AI는 휴리스틱 알고리즘, Pruning 필터, BM25 알고리즘 기반 정제로 불필요한 정보를 걸러 낸다. 이 필터링으로 AI 모델이 봐야 할 본문만 정확하게 뽑아낸다.
Playwright를 써서 자바스크립트 렌더링, 무한 스크롤, 지연 로딩 페이지 같은 동적 웹 페이지도 제어한다. 휴리스틱·BM25 기반 정제와 Playwright 기반 동적 웹 제어 말고도 사용자 정의 자바스크립트 실행, 세션 관리 같은 기능이 들어 있다.
효율적인 다중 페이지 및 딥 크롤링 전략
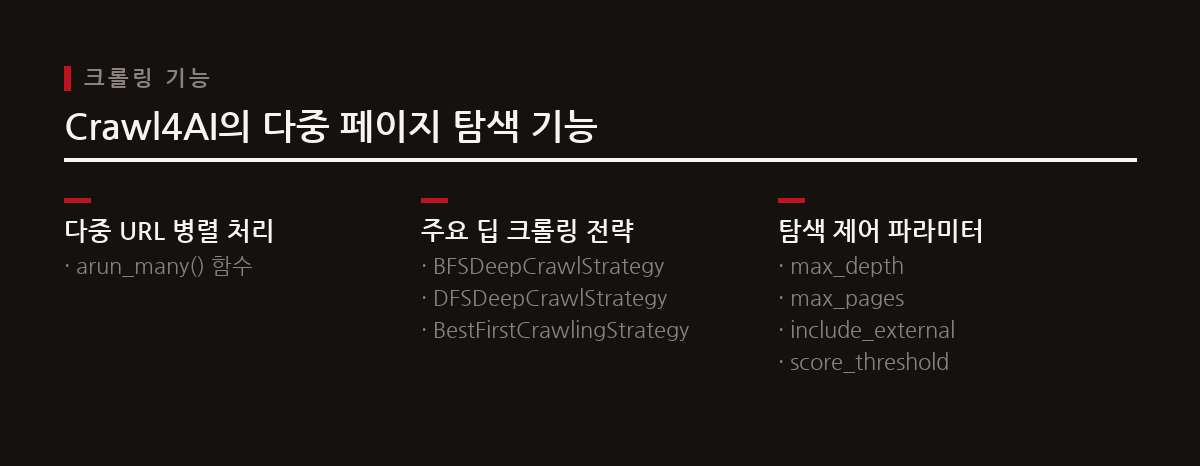
Crawl4AI는 페이지 하나만이 아니라 웹사이트 전체를 탐색할 수 있다. arun_many() 함수로 여러 URL을 병렬 처리해 대규모 웹 데이터를 빠르게 모은다.
max_depth, max_pages 같은 파라미터로 탐색 깊이와 수집 페이지 수를 세밀하게 조절한다. 딥 크롤링 전략은 너비 우선(BFS), 깊이 우선(DFS), 관련도 기반(Best-First) 가운데 고를 수 있다. 여러 페이지를 다루는 작업이라면 arun_many() 병렬 처리, max_depth와 max_pages 제어, BFS·DFS·Best-First 전략을 조합해 쓰면 된다.
AI 개발 생산성 향상을 위한 핵심 도구
Crawl4AI는 복잡한 웹 스크래핑과 데이터 정제를 자동화해 AI 개발자의 일을 크게 덜어 준다. 웹 페이지에서 필요한 데이터를 모으고 LLM이 바로 쓸 수 있는 품질 좋은 마크다운으로 바꾸는 과정이 간단해진다.
번거로운 웹 브라우저 제어와 세밀한 데이터 필터링도 이 도구가 처리한다. AI 에이전트나 LLM이 인터넷을 탐색하며 정보를 모아야 하는 경우, 안정적으로 믿고 쓸 수 있는 데이터 공급원이 된다.
참고
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.