 유명한형제들
인공지능 모델을 서비스에 도입하고 운영할 때 가장 핵심이 되는 개념 중 하나가 토큰이다. 거대 언어 모델은 텍스트나 이미지 같은 데이터를 일정 단위로 나누어 처리하며, 이 토큰의 수량에 따라 학습 및 추론 속도와 서비스 운영 비용이 결정된다. 입출력 구조에 따른 요금 체계와 모델별 처리 한계를 명확히 이해해야 애플리케이션의 성능을 유지하면서도 불필요한 비용 지출을 막을 수 있다.
인공지능의 기본 처리 단위, 토큰의 개념
인공지능 모델에서 토큰은 학습과 추론 과정 중에 처리하는 데이터의 기본 단위다. 거대 언어 모델은 원문 텍스트를 그대로 처리하지 않고 더 작은 정보 덩어리로 분해하여 가공한다. 사용자가 프롬프트를 입력하면 모델은 해당 문장을 입력 토큰으로 변환해 구조를 파악하며, 답변을 출력할 때도 토큰 단위로 새로운 문장을 생성한다.
언어별 특성에 따라 토큰화 방식과 생성되는 토큰 수에는 차이가 발생한다. 영어 텍스트의 경우 대략 1개 토큰이 약 4개의 알파벳 문자 또는 0.75개 단어에 해당한다. 반면 한국어는 형태소 단위로 토큰화되는 경우가 많아 동일한 의미의 문장이라도 영어보다 더 많은 토큰으로 분해되는 경향이 있다. 예를 들어 대한민국 헌법 전문 433자를 GPT-4o 토크나이저로 처리할 경우 277개 토큰으로 분석된다.

입출력 구조에 따른 AI 모델 비용 청구 방식
대부분의 생성형 인공지능 서비스는 사용자가 전송한 입력 토큰 수와 모델이 생성한 출력 토큰 수를 기준으로 비용을 산정한다. 처리해야 하는 토큰 수가 늘어날수록 모델 연산 시간이 길어지며 서버 운영 비용도 비례하여 증가하기 때문이다.
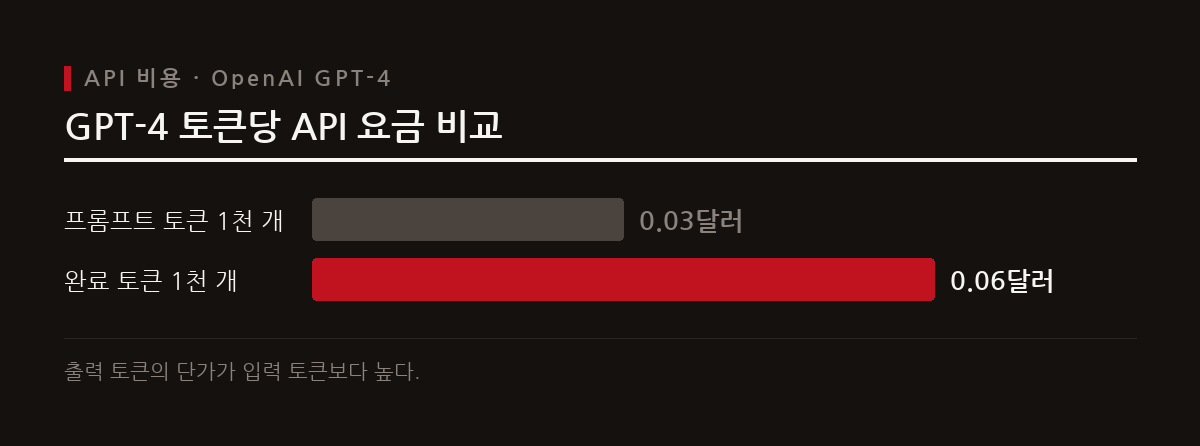
일반적으로 출력 토큰은 입력 토큰보다 높은 가격이 책정된다. 응답을 생성하는 연산 과정이 프롬프트를 읽어들이는 과정보다 더 많은 계산 자원을 소모하기 때문이다. 대표적으로 OpenAI GPT-4 API 서비스는 프롬프트(입력) 토큰 1천 개당 0.03달러를 부과하는 반면, 완료(출력) 토큰 1천 개당 0.06달러를 요금으로 책정하고 있다. 따라서 시스템을 설계할 때는 출력 결과를 간결하게 유도하는 프롬프트 작성이 비용 절감에 직접적인 영향을 미친다.
모델별 컨텍스트 윈도우와 토큰 처리 한계
각 인공지능 모델은 한 번에 수용하고 처리할 수 있는 최대 토큰 수인 컨텍스트 윈도우 한계를 지닌다. 대화 내역이나 참조 문서가 이 한계를 초과하면 모델은 이전 맥락을 잊거나 오류를 발생시킨다. 모델의 버전과 목적에 따라 이러한 컨텍스트 윈도우 규격은 크게 다르게 설정되어 있다.
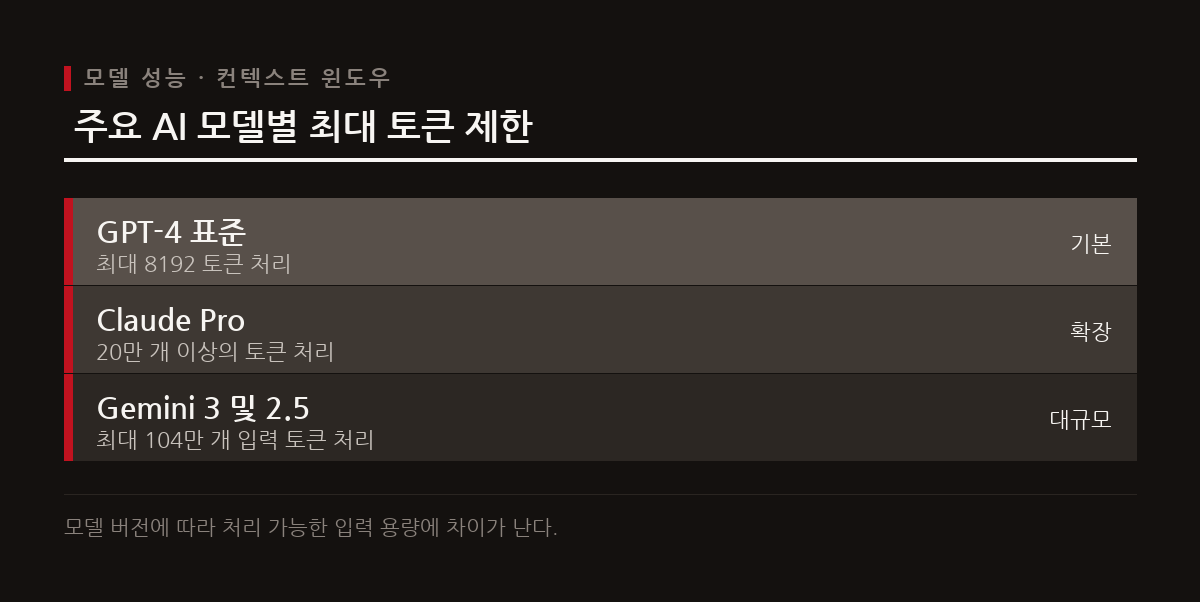
GPT-4 표준 버전은 최대 8,192 토큰의 컨텍스트 윈도우를 지원하지만, GPT-4 Turbo는 이를 128k(128,000) 토큰까지 확장했다. Claude Pro 버전의 경우 20만 개 이상의 토큰을 지원하여 약 500페이지 분량의 텍스트를 한 번에 다룰 수 있다. 구글의 Gemini 2.5 및 3 모델은 입력 토큰 예산으로 1,048,576 토큰을 제공하고 출력 토큰 예산으로 65,536 토큰을 할당하여 대규모 데이터를 동시에 처리할 수 있는 환경을 마련했다. 다만 Gemini 2.5 Pro의 무료 사용자 기준 컨텍스트 윈도우는 32,000 토큰으로 제한된다.
실리콘밸리의 토큰 맥싱과 비용 효율화 전략
최근 IT 업계와 실리콘밸리에서는 개발자와 기술직 종사자들이 AI 토큰 사용량을 경쟁적으로 늘리고 과시하는 토큰 맥싱 현상이 나타났다. 사내에서 토큰 사용량이 일종의 평판 자산으로 작동하거나, AI에 투입하는 비용 규모 자체가 개인이나 팀의 생산성을 나타내는 수단으로 오용된 것이다.
그러나 사용량이 증가함에 따라 운영 비용이 급격히 상승하면서 토큰 맥싱에 대한 반성적 흐름이 커지고 있다. 무조건 최고 사양의 모델을 고집하기보다 개별 작업의 목적과 난이도에 맞는 최적의 모델을 선택하고 불필요한 맥락 입력을 줄이는 토크노믹스 전략이 정착하고 있다. 개발자는 각 모델의 요금 체계와 컨텍스트 한계를 파악하여 비용 대비 최선의 성능을 끌어내는 시스템 구조를 설계해야 한다.

참고
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.