 유명한형제들
프론티어 AI 모델의 기술 경쟁이 2026년 가을 들어 새 국면에 들어섰다. OpenAI와 Anthropic이 장기 에이전트 작업과 거대 컨텍스트 처리에 맞춘 최신 모델을 나란히 내놓았기 때문이다. 개발 환경에 맞는 모델을 고르려면 비용 효율과 성능을 꼼꼼히 비교해야 한다.
GPT-6 Astra와 Claude Fable 5.1의 동시 등장
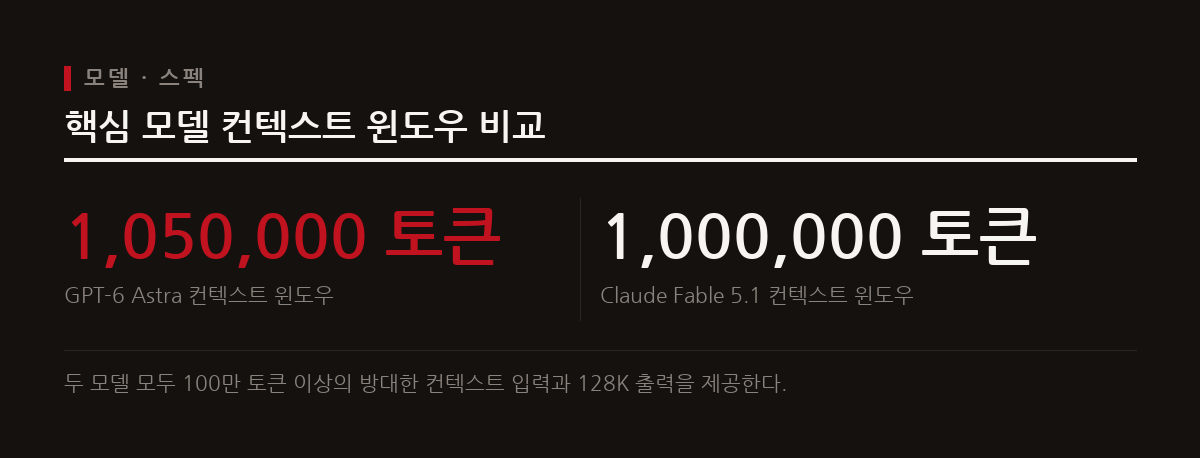
2026년 9월 프론티어 AI 모델인 GPT-6 Astra와 Claude Fable 5.1이 잇따라 나오면서 100만 토큰급 컨텍스트 시대가 열렸다. OpenAI는 2026년 9월 3일, 105만 토큰 컨텍스트 윈도우를 갖춘 GPT-6 Astra를 공개했다. 이에 맞서 Anthropic은 장기 에이전트 작업에 특화한 Claude Fable 5.1을 2026년 9월 1일 출시했다. 이 모델도 100만 토큰 컨텍스트를 지원한다. 두 모델 모두 최대 12만 8천 토큰까지 출력할 수 있고 코딩과 추론에 맞춰 최적화되었다.
요금 정책과 캐싱으로 갈린 프롬프트 비용 구조
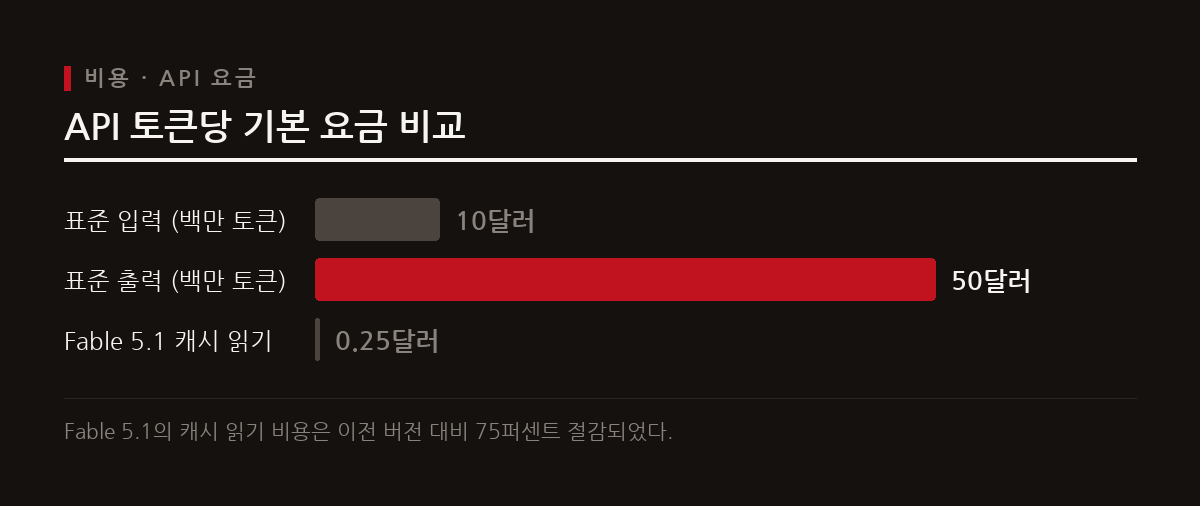
두 모델의 기본 API 가격은 입력 백만 토큰당 10달러, 출력 백만 토큰당 50달러로 같다. 하지만 세부 과금 방식은 크게 다르다. GPT-6 Astra는 입력 프롬프트가 27만 2,000 토큰을 넘으면 프롬프트 전체에 입력 및 캐시 요금 2배, 출력 요금 1.5배의 할증을 붙인다. Claude Fable 5.1은 캐시 읽기 비용을 백만 토큰당 0.25달러로 크게 낮췄다. 덕분에 에이전트 중심 워크로드의 총비용을 최대 약 45퍼센트 줄일 수 있도록 설계됐다.
코딩 및 과학 추론 벤치마크 성능
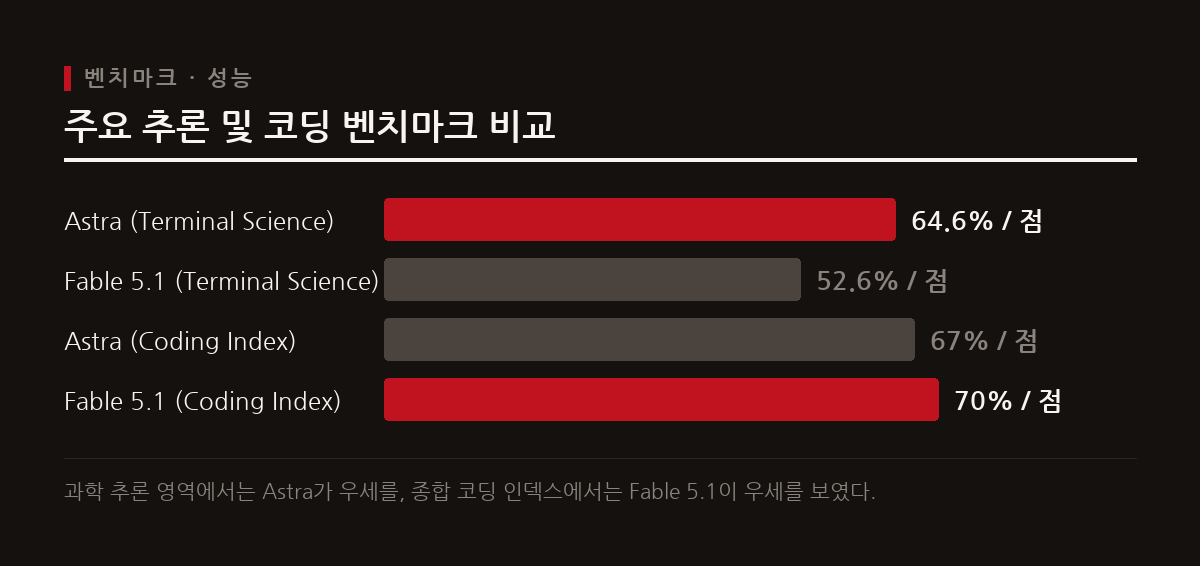
벤치마크 결과에서도 두 모델의 성격이 갈렸다. Terminal-Bench Science 과학 추론 평가에서는 GPT-6 Astra가 64.6퍼센트로 Claude Fable 5.1의 52.6퍼센트를 앞섰다. 실무 코딩에서는 결과가 달랐다. Artificial Analysis 코딩 에이전트 인덱스에서 Claude Fable 5.1은 70점으로 GPT-6 Astra의 67점보다 조금 높았다. CursorBench 3.2 에이전트 코딩 테스트에서도 Claude Fable 5.1은 73.4퍼센트를 기록해 나아진 코딩 능력을 보여 줬다.
터미널과 클라우드 환경의 코딩 에이전트
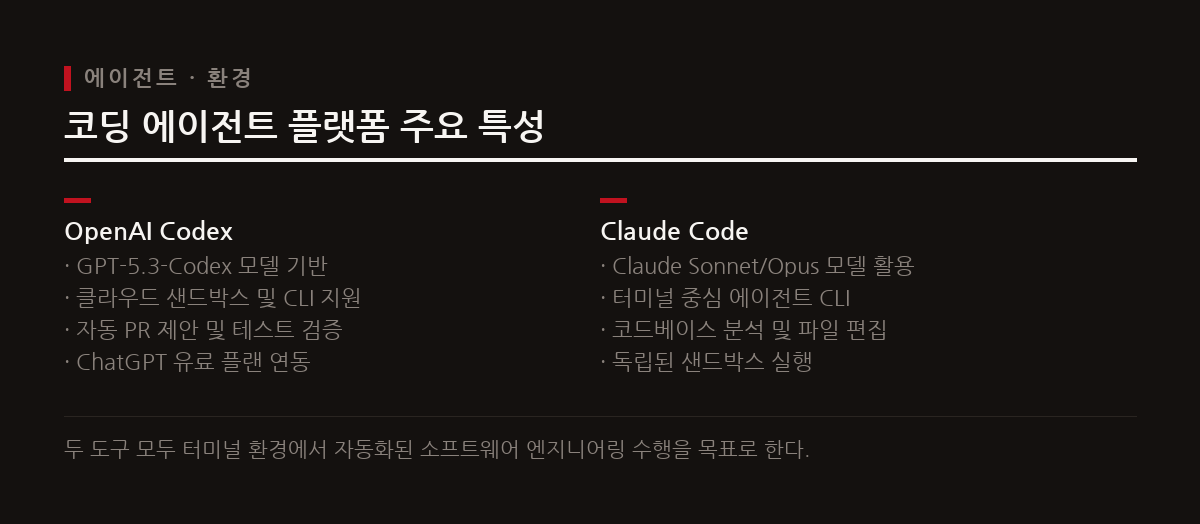
이 모델들은 코딩 에이전트 환경과 짝을 이뤄 쓰인다. OpenAI Codex는 GPT-5.3-Codex를 기반으로 돌아가며, 자체 클라우드 샌드박스와 터미널 CLI 환경을 모두 제공해 격리된 작업 환경을 보장한다. Anthropic의 Claude Code는 자연어 지시를 로컬 터미널에서 해석해 코드 분석, 편집, 테스트를 수행하는 CLI 도구다. 두 에이전트 모두 GitHub 통합, 자동 PR 제출, 버그 수정, 테스트 하네스 검증 기능을 갖추고 있다.
개발자를 위한 프론티어 AI 도입 전략
개발자는 작업 패턴에 따라 모델을 가려 써야 한다. 많은 코드를 한꺼번에 넣는 작업이라면 GPT-6 Astra의 27만 2,000 토큰 초과 할증 구간을 특히 조심해야 한다. 캐시를 자주 쓰는 에이전트 세션이라면 Claude Fable 5.1의 캐시 할인을 이용하는 편이 훨씬 싸다. 터미널 기반 로컬 작업 흐름과 클라우드 샌드박스의 자동화 편의성 가운데 프로젝트 성격에 맞는 도구를 골라야 효과를 제대로 볼 수 있다.
참고
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.