 유명한형제들
실제 환경을 찍은 비디오를 분석해 로봇이 움직일 수 있는 가상 3D 시뮬레이션 공간으로 바꾸는 기술은 체화된 AI 분야의 핵심 과제다. 기존 스캔 방식으로는 개별 객체를 조작하기 어려웠는데, 바이트댄스 시드 연구진이 개발한 루시다는 이 문제를 풀었다. 루시다는 실내 비디오 속 물체들을 편집하고 조작할 수 있는 완전한 3D 자산으로 복원한다.
비디오를 편집 가능한 3D 공간으로 바꾸는 루시다
바이트댄스 시드 연구진이 공개한 루시다는 실내 영상을 로봇 시뮬레이션과 체화된 AI 개발용 3D 환경으로 정교하게 바꾸는 기술이다. 비디오 속 실제 객체를 관찰된 상태 그대로, 완전하고 편집 가능한 3D 자산으로 복원하는 데 초점을 둔다.
바탕에는 실세계를 가상 공간으로 옮기는 Real-to-Sim 파이프라인이 있다. 장면을 통째로 스캔하지 않고 객체 단위로 나눠 복원하기 때문에 로봇 학습용 가상 환경을 빠르게 만들 수 있다.
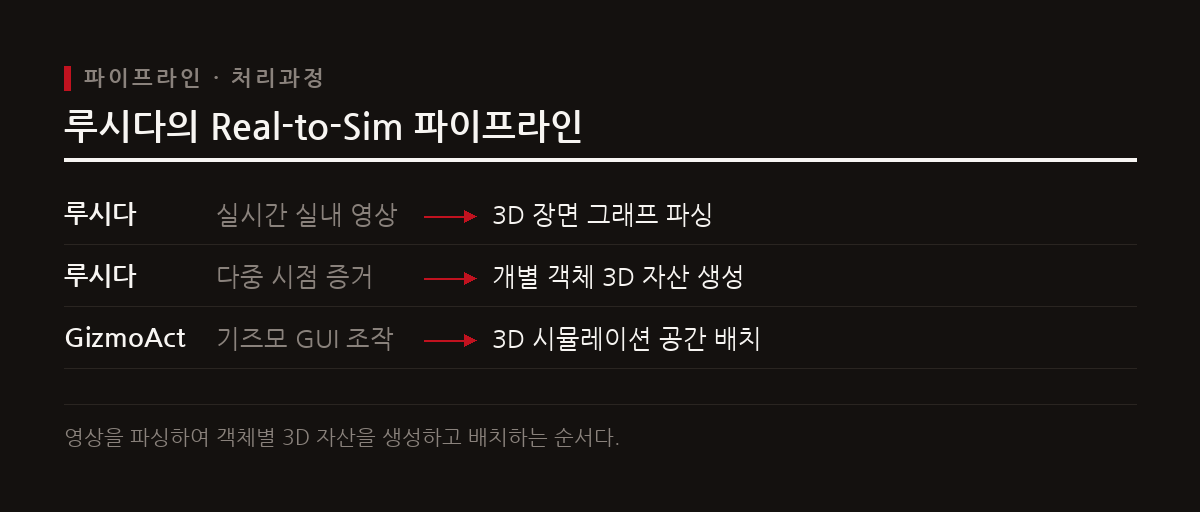
객체 파싱부터 GizmoAct 배치까지의 핵심 동작
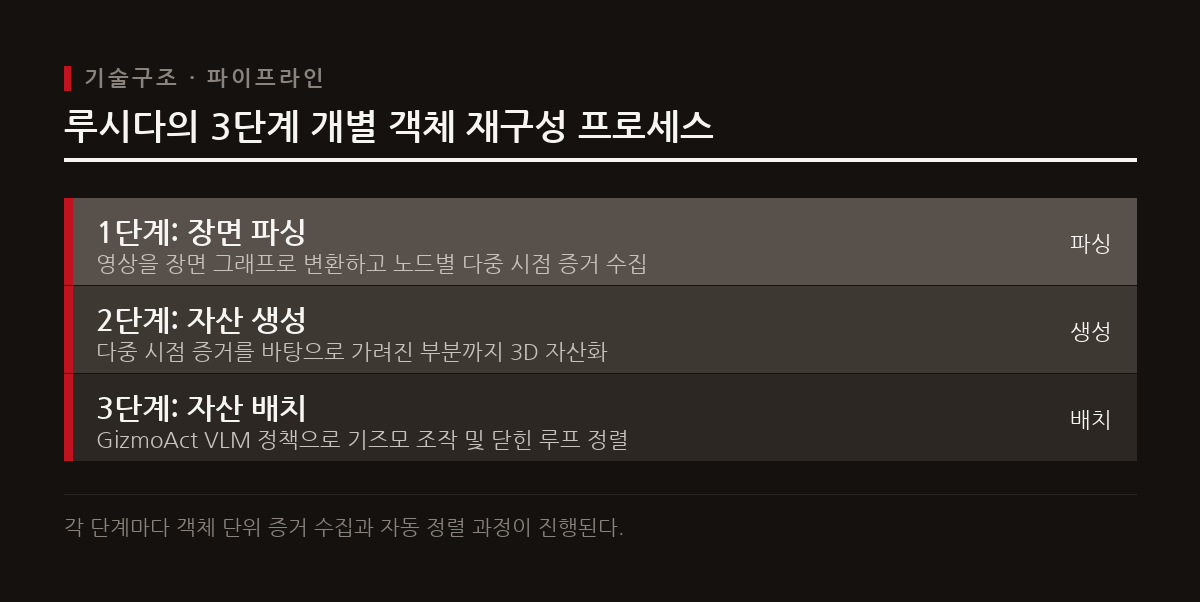
루시다는 비디오를 장면 그래프로 파싱하고 각 노드에서 인스턴스별 다중 시점 증거를 뽑아낸다. 연구진이 마스크나 포인트클라우드 수집을 직접 하는지는 명시되지 않았지만, 다중 시점 정보를 이용해 가려진 부분까지 정교하게 추정한다. 개별 객체 재구성은 3단계 프로세스를 거쳐 끝난다.
자산 배치는 비전 언어 모델 정책인 GizmoAct가 맡는다. GizmoAct는 다중 턴 GUI 상호작용으로 3D 기즈모를 조작해 객체를 정교하게 배치한다. 정렬이 끝났는지는 시스템이 닫힌 루프 피드백으로 스스로 판단하고, 마지막 미세 조정까지 마무리한다.
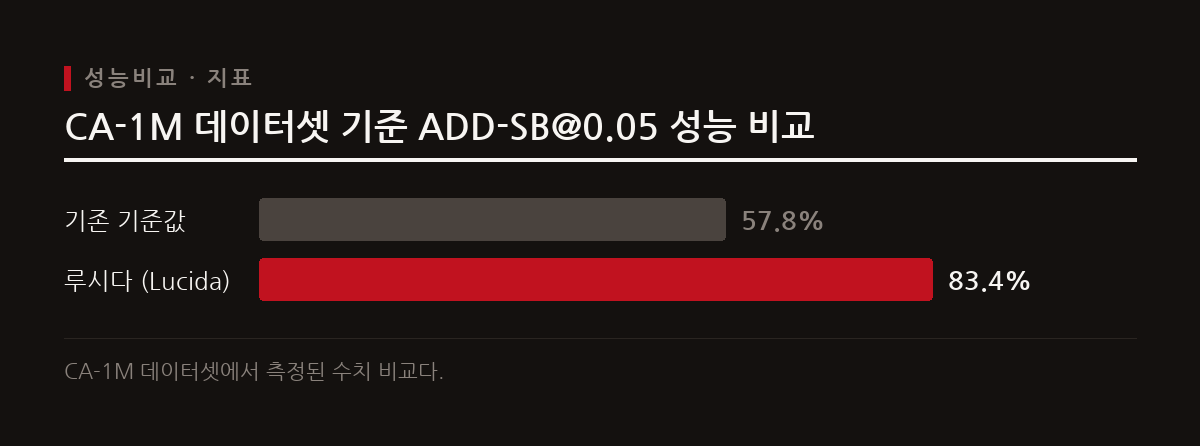
기존 모델 대비 주요 성능 지표 비교
루시다는 3D 객체 감지와 장면 재구성 벤치마크에서 좋은 결과를 냈다. 장면 수준 3D 객체 감지에서는 Boxer보다 mAP가 69% 높았고, 장면 분할을 재는 F-점수에서는 SAM3D의 0.794를 크게 웃도는 0.924를 기록했다.
자세 추정 정확도를 보여 주는 [email protected] 평가에서도 개선 폭이 컸다. CA-1M 데이터셋 기준으로 기존 벤치마크 모델들이 기록한 정확도 57.8%를 루시다는 83.4%까지 끌어올렸다. 물리 시뮬레이션의 정확도와 직결되는 지표다.
로봇 시뮬레이션과 체화된 AI를 위한 고도화
루시다는 체화된 AI 분야에서 손으로 하던 가상 환경 구축 작업을 완전히 자동화한다. 일상에서 간단히 찍은 비디오만으로 로봇이 쥐고 흔들 수 있는 개별 조작 자산을 가상 공간 안에 바로 만들 수 있기 때문이다.
다중 턴 상호작용과 자율 정렬 기능을 활용하면 대규모 로봇 학습용 데이터셋을 만들기도 쉬워진다. AI를 직접 다루는 개발자라면 루시다의 오픈소스를 참고해 실제 공간을 바탕으로 한 정밀한 시뮬레이션 환경을 직접 구축해 볼 만하다.
참고
댓글 0개
아직 댓글이 없습니다. 첫 댓글을 남겨보세요.